

„Ich möchte jeden Morgen um 8 Uhr nur die neuen Produkte der Konkurrenz, die gestern hinzugekommen sind, sowie ausverkaufte Produkte zusammengefasst erhalten.“
Damit sind die Anforderungen in einer Zeile erledigt. Doch wenn man Angebote einholt, driftet das Gespräch immer wieder zu „Kann diese Website gesammelt werden?“ ab.
Der schwierige Teil dieser Anfrage ist nicht die Datenerfassung.
Die Produktlisten der Wettbewerber sind auch jetzt schon vollständig auf dem Bildschirm sichtbar. Man sieht sie, sobald man die Seite öffnet.
Nur eines ist nicht sichtbar: Welche davon gestern noch nicht da waren.
Preise stehen auf dem heutigen Bildschirm. Neue Produkte und Ausverkäufe existieren nur, wenn es eine Liste von gestern gibt.
Zusammenfassung in 3 Zeilen (TL;DR)
- Neue Produkte und Ausverkäufe sind keine Werte, die von einer Seite ausgelesen werden, sondern die Differenz (diff) zwischen der Liste von gestern und der Liste von heute. Daher ist das erste Designobjekt nicht der Crawler, sondern ein Referenz-Snapshot, der täglich nach denselben Kriterien gespeichert wird.
- Die zweite Hürde ist, dass Ausverkaufskennzeichnungen nicht standardisiert sind. Ausverkauft, vorübergehend ausverkauft, Benachrichtigung bei Wiedereinlagerung und Ausverkauf auf Optionsbasis werden je nach Website unterschiedlich verwendet. Ohne eine Definition dessen, was als ausverkauft zählt, häufen sich täglich Zahlen, die mit unterschiedlichen Maßstäben gemessen wurden.
- „Jeden Morgen“ ist nicht die Erfassungszeit, sondern die Zustellzeit. Wenn der Bericht um 8 Uhr eintreffen soll, müssen auch Zeit für Prüfung und Wiederholungsversuche rückwärts eingeplant werden. Werden ohne Schwellenwerte alle Meldungen verschickt, öffnet sie ab der dritten Woche niemand mehr.
Inhaltsverzeichnis
- Was sind Monitoring für neue Produkte und Ausverkaufsmonitoring
- Wenn Sie die Liste von gestern wegwerfen, werden Sie die neuen Produkte von heute nie sehen
- Ausverkauft wird je nach Website anders bezeichnet
- Jeden Morgen ist nicht die Erfassungszeit, sondern die Zustellzeit
- Einen Bericht mit 200 Meldungen pro Tag schaut ab der dritten Woche niemand mehr an
- Vergleichstabelle der Methoden: manuelle Prüfung vs. No-Code-Tool vs. Managed Service
- 5 Fragen zur Selbstdiagnose vor dem Start
- 5 Schritte zur Einführung
- Häufig gestellte Fragen
- Fazit
Was sind Monitoring für neue Produkte und Ausverkaufsmonitoring
Monitoring für neue Produkte ist die Tätigkeit, bei der Produktlisten von Wettbewerbern und Vertriebskanälen in festgelegten Intervallen erfasst werden, um automatisch festzustellen, ob Produkte neu erschienen sind, die zum Referenzzeitpunkt noch nicht vorhanden waren.
Ausverkaufsmonitoring ist die Tätigkeit, bei der der Verkaufsstatus desselben Produkts regelmäßig erfasst wird, um Momente zu erkennen, in denen sich der Status ändert, etwa Verkauf → ausverkauft oder ausverkauft → wieder verfügbar.
In beiden Definitionen stehen dieselben Worte: nicht vorhanden und verändert.
Hier liegt der Unterschied zum Preis-Monitoring.
Für Preise genügt eine einzige heutige Seite. Denn die Zahl steht auf dem Bildschirm.
Neue Produkte und Ausverkäufe lassen sich nicht allein anhand der heutigen Seite beantworten. Es braucht ein Gestern zum Vergleichen.
Deshalb ähnelt diese Arbeit eher einem Abgleich als einer Erfassung. Die Designkriterien für Preis-Monitoring sind separat in Datenerfassungsdienste für E-Commerce-Preisvergleich und -Monitoring: Wie wählt man sie aus? zusammengefasst.
Wenn Sie die Liste von gestern wegwerfen, werden Sie die neuen Produkte von heute nie sehen
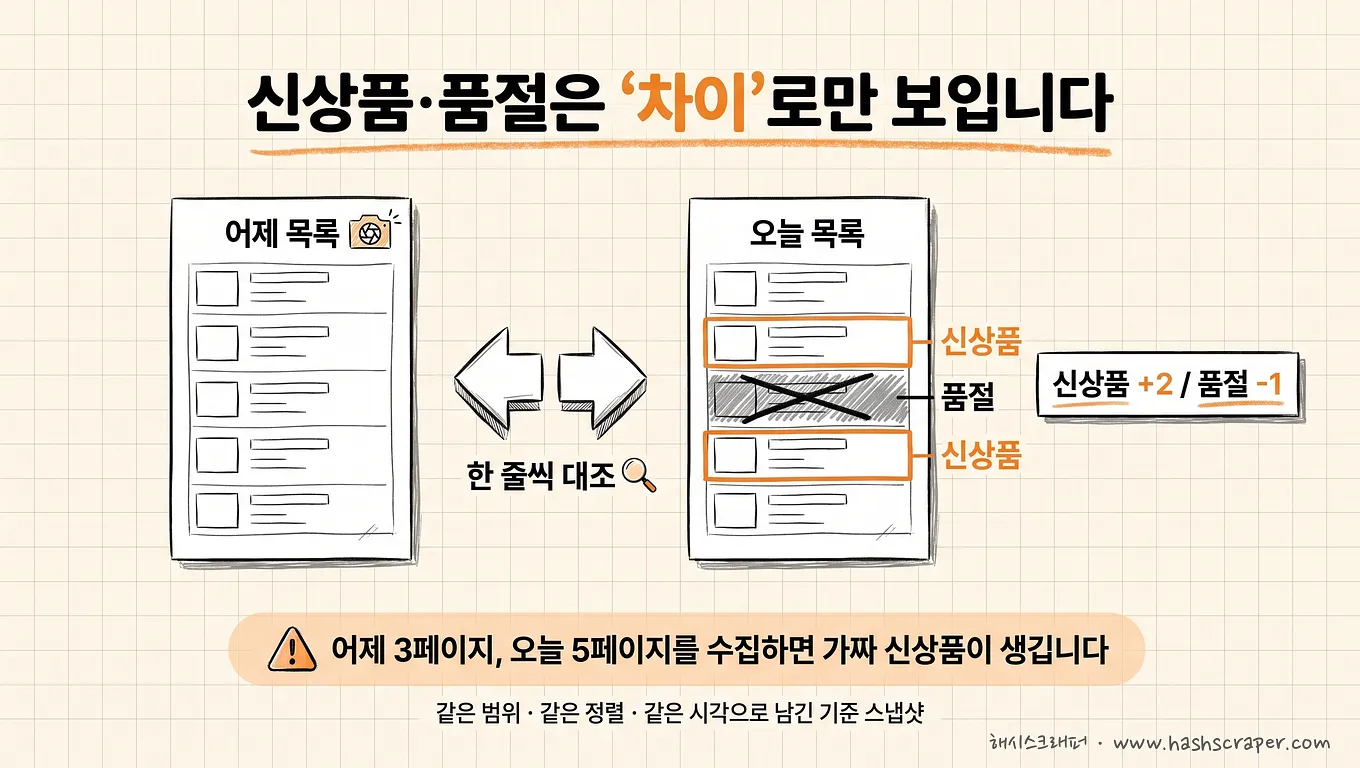
Ein Referenz-Snapshot sind Daten, bei denen die vollständige Produktliste und deren Status zu einem bestimmten Zeitpunkt gespeichert werden, um sie bei der nächsten Ausführung als Vergleichsgrundlage zu verwenden.
Damit der Abgleich funktioniert, müssen drei Dinge festgelegt sein.
- Identifikator — Was gilt als dasselbe Produkt? (Produkt-ID · URL · Produktname + Option)
- Umfang — Ist der Erfassungsumfang gestern und heute derselbe?
- Zeitpunkt — Wird täglich zur gleichen Uhrzeit ein Snapshot erstellt?
Die meisten Probleme entstehen beim zweiten Punkt.
Wenn gestern drei Listenseiten und heute fünf Seiten erfasst wurden, erscheinen im Bericht Dutzende neuer Produkte. Obwohl kein einziges davon tatsächlich neu ist.
Ein noch schwierigeres Problem bleibt. Ein Produkt, das man zum ersten Mal sieht, ist nicht automatisch ein neues Produkt.
Es gibt mindestens vier Fälle, in denen ein Produkt erstmals in der Liste erscheint.
- Echtes neues Produkt — neu auf den Markt gebracht
- Neuregistrierung nach Überarbeitung — Produktseite wegen geänderter Größe oder Verpackung neu angelegt
- Zusätzliche Option — Farben oder Größen wurden zu einem bestehenden Produkt hinzugefügt und erscheinen wie ein separates Produkt
- Rückkehr nach Wiedereinlagerung — war wegen Ausverkaufs aus der Liste entfernt und ist wieder zurückgekehrt
Der vierte Fall ist ein besonders unauffälliger Fehlalarm. Viele Websites entfernen ausverkaufte Produkte vollständig aus der Liste, sodass Wiedereinlagerungen jedes Mal als neue Produkte erkannt werden.
Die Unterscheidung erfolgt nicht durch Technologie, sondern durch Regeln. Wurde eine neue Produkt-ID vergeben? Soll ein Produkt bei Überschreiten eines Ähnlichkeitsschwellenwerts des Produktnamens als Überarbeitungskandidat ausgeschlossen werden? Soll es als Wiedererscheinen gelten, wenn es innerhalb der letzten 30 Tage in der Liste war?
Bei der Unterstützung von Datenerfassungen für mehr als 500 Unternehmen war der erste Fehler bei Berichten über neue Produkte meist keine Sperrung. Es war der Zustand, dass keine Liste von gestern gespeichert war.
Wer schreibt diese Regeln, und wer hält sie ein, auch wenn die Website umgestaltet wird? Dieses Projekt besteht im Kern genau aus dieser einen Frage.
Ausverkauft wird je nach Website anders bezeichnet
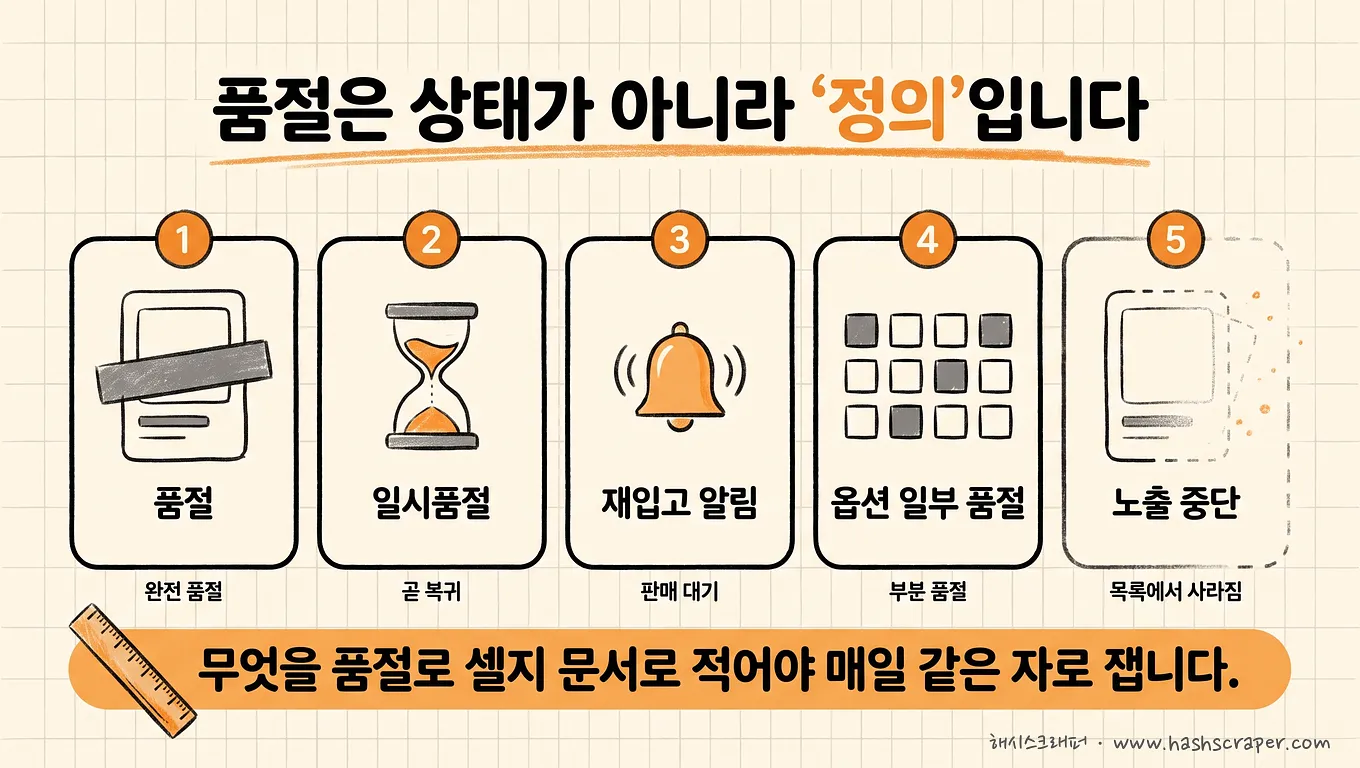
Auch Ausverkauf ist nicht nur ein einzelner Wert. Dasselbe „Derzeit nicht kaufbar“ wird je nach Website unterschiedlich dargestellt.
- Ausverkauft / vorübergehend ausverkauft / Wiedereinlagerung geplant / Verkauf eingestellt
- Der Kaufbutton verschwindet und nur „Benachrichtigung bei Wiedereinlagerung anfordern“ bleibt
- Der Button bleibt bestehen, aber beim Öffnen der Optionen sind alle nicht auswählbar
- Nur 3 von 12 Optionen sind ausverkauft (das Produkt selbst wird weiterhin verkauft)
- Vollständig aus den Suchergebnissen verschwunden
Hier ist eine operative Entscheidung erforderlich.
„Wenn bei einem Produkt 3 von 12 Optionen ausverkauft sind: Ist das Produkt ausverkauft oder nicht?“
Kann das Team diese Frage nicht mit einem Satz beantworten, sind die täglich eintreffenden Ausverkaufszahlen jeden Tag nach einem anderen Maßstab gezählt.
Ein praktikabler Ansatz ist die Erfassung auf zwei Ebenen.
- Produktebene — Ist es derzeit kaufbar? (möglich / nicht möglich)
- Optionsebene — Wie viele der gesamten Optionen sind nicht verfügbar?
Zusätzlich sollte die auf dem Bildschirm angezeigte Originalkennzeichnung gespeichert werden. Denn wenn eine Website ihre Formulierung ändert, lassen sich historische Daten rückwirkend erneut klassifizieren.
Der letzte Punkt, das Verschwinden aus den Suchergebnissen, muss separat betrachtet werden. Ob es ausverkauft ist, der Verkauf beendet wurde oder sich unser Erfassungsumfang verändert hat — alle drei Fälle sehen auf dem Bildschirm gleich aus.
Ausverkauft ist kein Status, sondern eine Definition. Ohne dokumentierte Definition häufen sich täglich Zahlen, die mit unterschiedlichen Maßstäben gemessen wurden.
Jeden Morgen ist nicht die Erfassungszeit, sondern die Zustellzeit
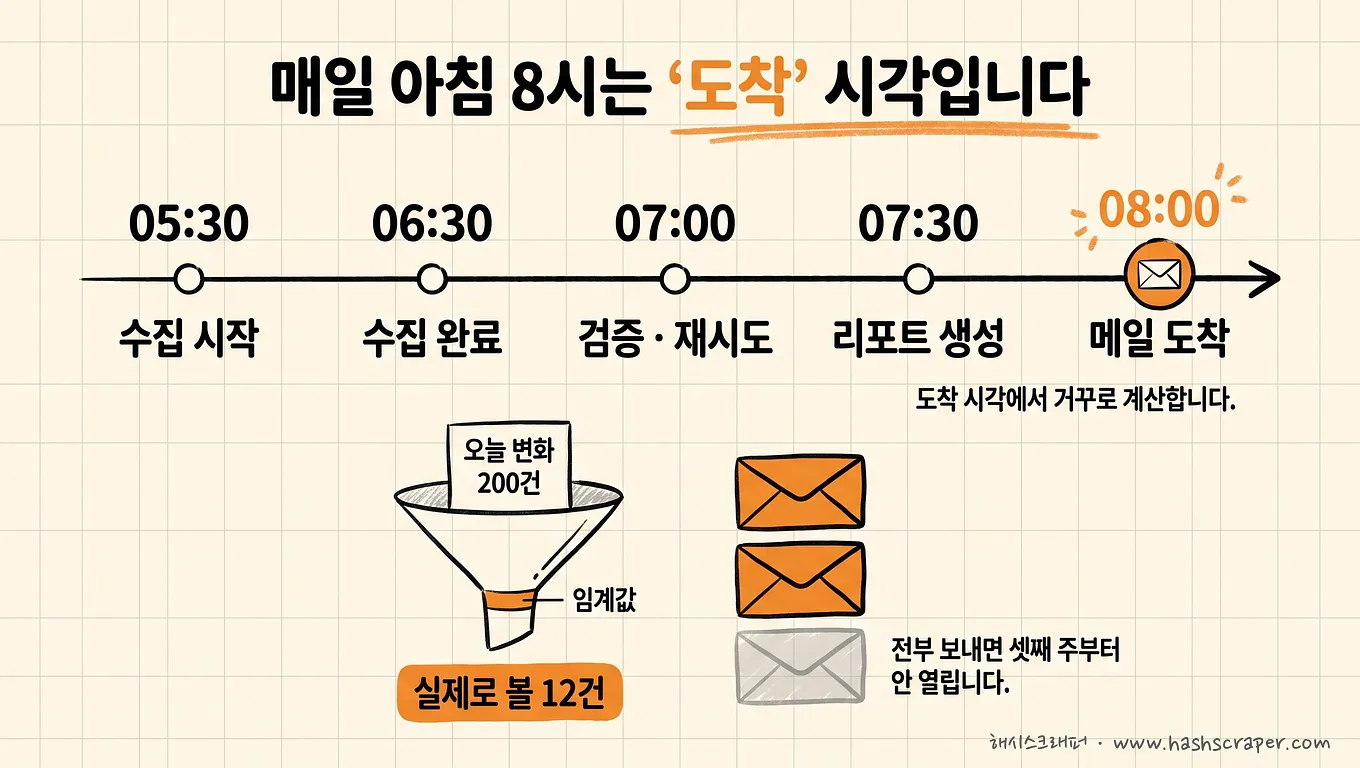
Die Anforderung lautet „E-Mail um 8 Uhr morgens“, doch das Design endet meist bei „Crawler nachts ausführen“. Die Reihenfolge muss umgedreht werden.
Es wird von der Zustellzeit rückwärts gerechnet. Je nach Umfang der Ziele und Schwierigkeit der Websites variiert dies, doch die Grundstruktur sieht so aus.
| Uhrzeit | Aufgabe |
|---|---|
| 08:00 | Bericht trifft im E-Mail-Postfach oder Slack des Verantwortlichen ein (das ist die Anforderung) |
| 07:40 | Bericht erstellen und versenden |
| 07:00 | Konsistenzprüfung + Abgleich mit dem Snapshot von gestern |
| 05:30 | Erfassung starten — einschließlich Puffer für Wiederholungsversuche bei Fehlern |
| Vortag 05:30 | Snapshot als Vergleichsgrundlage |
Zwei Felder bleiben häufig leer: Prüfung und Wiederholungsversuch.
Wenn der Zeitplan unter der Annahme erstellt wird, dass die Erfassung beim ersten Versuch erfolgreich ist, ist der Bericht an Fehler-Tagen leer oder verspätet. Eine Pipeline ohne Puffer bleibt an Fehler-Tagen still.
Auch der Snapshot-Zeitpunkt muss täglich gleich bleiben. Wenn gestern um 3 Uhr nachts und heute um 9 Uhr morgens erfasst wird, können Produkte, die dazwischen erschienen sind, auf zwei Tage verteilt erkannt werden oder vollständig fehlen.
Schwierig ist nicht „morgens“, sondern „jeden Tag“. Einmal etwas zu bauen dauert einen Tag; dafür zu sorgen, dass es jeden Tag zur gleichen Uhrzeit nach denselben Kriterien eintrifft, ist Betrieb.
Einen Bericht mit 200 Meldungen pro Tag schaut ab der dritten Woche niemand mehr an
Wenn bei drei Wettbewerbern die gesamte Kategorie überwacht wird, entstehen täglich Hunderte Änderungen bei neuen Produkten und Ausverkäufen.
In der ersten Woche liest man alles. In der zweiten Woche überfliegt man es. Ab der dritten Woche öffnet man es nicht mehr.
Deshalb machen Schwellenwerte die Hälfte des Berichtsdesigns aus.
- Umfang — Nicht mit allen Kategorien beginnen, sondern mit Kategorien, Preisbereichen und Marken, auf die wir tatsächlich reagieren
- Priorität — Neue Produkte in Kernkategorien und Ausverkäufe von Produkten, die mit unseren Bestsellern konkurrieren, oben fixieren
- Bündelung — Nicht einzeln versenden, sondern eine tägliche Zusammenfassung. Die Top 10 oben, alles Weitere als Anhang
- Empfänger — Neue Produkte an Produktplanung, Ausverkäufe an Vertrieb und MD. Niemand soll Benachrichtigungen erhalten, die ihn nicht betreffen
Das Ziel eines Berichts ist nicht, alles zu zeigen. Es ist, nur das übrig zu lassen, was heute angesehen werden muss.
Die Gestaltung eines Regelkreises von Erkennung bis Reaktion ist in Monitoring ist keine Datenerfassung, sondern Benachrichtigung — einen Reaktionskreislauf schaffen zusammengefasst.
Vergleichstabelle der Methoden: manuelle Prüfung vs. No-Code-Tool vs. Managed Service
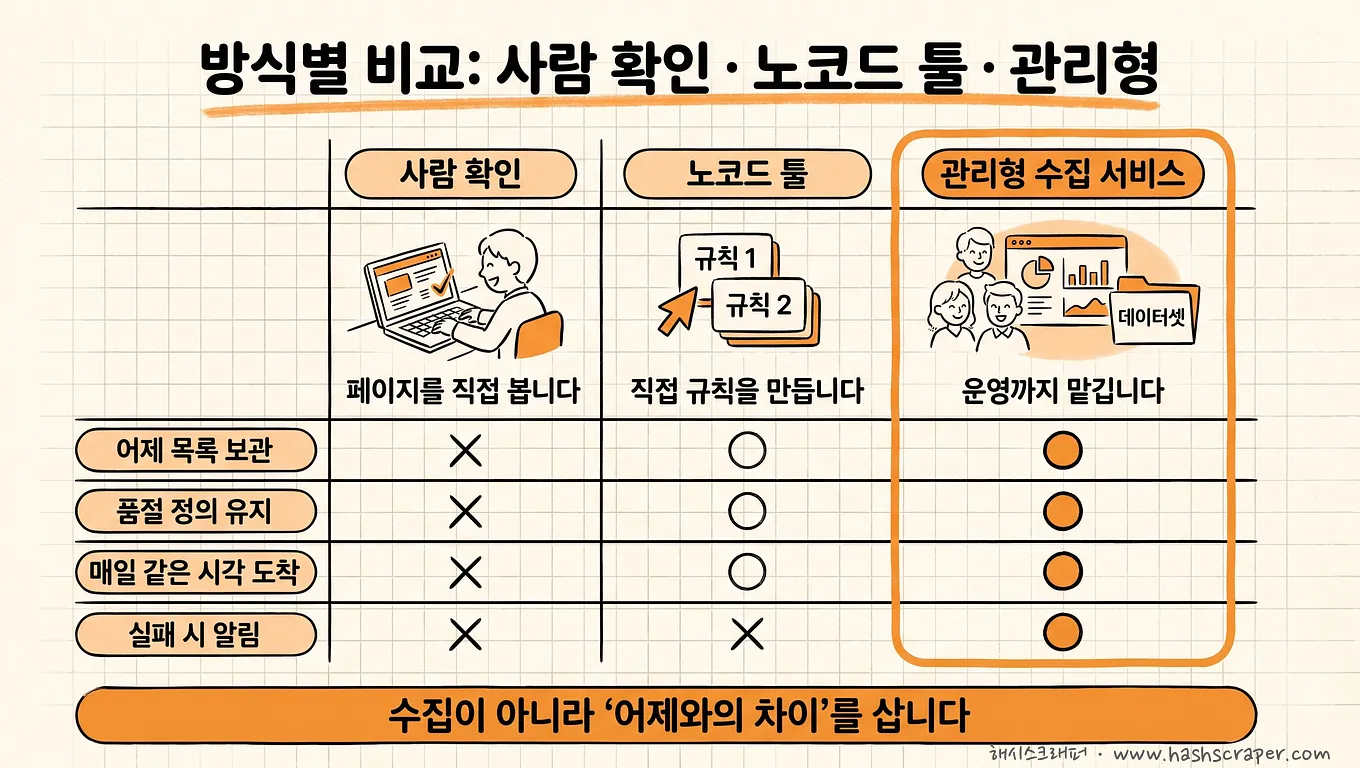
Ein Managed Data Collection Service ist ein abonnementbasierter Dienst, bei dem ein Anbieter die Entwicklung von Crawlern, den Umgang mit Sperren, Reparaturen bei Website-Änderungen, Anomalieerkennung und termingerechte Lieferung übernimmt, während Unternehmen nur die Ergebnisberichte erhalten.
Vergleicht man die drei Methoden anhand derselben Kriterien, ergeben sich folgende Unterschiede.
| Kategorie | Tägliche manuelle Prüfung | No-Code-Tool mit Scheduler | Managed Data Collection Service |
|---|---|---|---|
| Typische Tools | Browser-Lesezeichen | Octoparse, Thunderbit usw. | Hashscraper usw. |
| Erkennung neuer Produkte (Differenz zu gestern) | Gedächtnis und Sichtprüfung | Ergebnisse pro Durchlauf sind vorhanden — der Abgleich liegt meist beim Nutzer | Snapshot-Speicherung + Erkennungsregeln werden als Anforderung gestaltet |
| Umgang mit Ausverkaufskennzeichnungen | Menschliche Beurteilung | Erfasst die festgelegten Elemente unverändert | Erstellt und pflegt ein Wörterbuch der Kennzeichnungen je Website |
| Tägliche termingerechte Lieferung | Abhängig von der Arbeitszeit des Verantwortlichen | Geplante Cloud-Ausführung (laut offizieller Website) | Planung und Betrieb durch Rückwärtsrechnung von der Zustellzeit |
| Anomalieerkennung (leere Werte · starke Mengenschwankungen) | Wenn ein ungewöhnliches Gefühl entsteht | Nutzer muss selbst prüfen | Einschließlich Mengenverlauf und Prüfung von Pflichtwerten (99,7 % Genauigkeit) |
| Bei Website-Überarbeitungen | Mehr manueller Aufwand | Nutzer repariert die Regeln | Anbieter erkennt und repariert Änderungen (im Abonnement enthalten) |
| Geeignete Situation | Höchstens 10 Ziele · einmal pro Woche | Wenige Ziele · stabile Struktur · eigener Betrieb möglich | Die tägliche Morgenmeldung ist geschäftskritisch |
Die entscheidenden Zeilen in der Tabelle sind die beiden oberen: Erkennung neuer Produkte und Umgang mit Ausverkaufskennzeichnungen. Alles andere ist das Ergebnis dieser Entscheidung.
Nicht weil No-Code-Tools unzureichend wären. Sondern weil beide Zeilen keine Funktions-, sondern Definitionsfragen sind. Octoparse und Thunderbit führen nach Erstellung der Regeln auch die geplante Ausführung zuverlässig durch (laut den jeweiligen offiziellen Websites). Die Beurteilung „Vergleiche mit gestern und behalte nur die neu entstandenen Zeilen“ bleibt jedoch weiterhin Aufgabe des Menschen.
Wenn ein Entwicklungsteam vorhanden ist, gibt es eine vierte Option. Man kauft die Erfassungsschicht über Scraping-APIs für Entwickler wie Zyte oder Firecrawl ein und erstellt Snapshot-Speicherung, Abgleich und Berichtserstellung selbst (laut den jeweiligen offiziellen Websites). Diese Kombination bietet die größte Freiheit.
Doch die drei in diesem Artikel behandelten Punkte — Snapshot-Verwaltung, Wörterbuch für Ausverkaufskennzeichnungen und termingerechte Lieferung — werden von keiner API definiert. Sie bleiben vollständig bei der entwickelnden Seite.
Hashscraper bietet diesen Managed-Ansatz auf Grundlage von Erfahrungen mit der Erfassung von über 5.000 koreanischen Websites und Proxys in 195 Ländern an und wird von mehr als 500 Unternehmen genutzt.
5 Fragen zur Selbstdiagnose vor dem Start
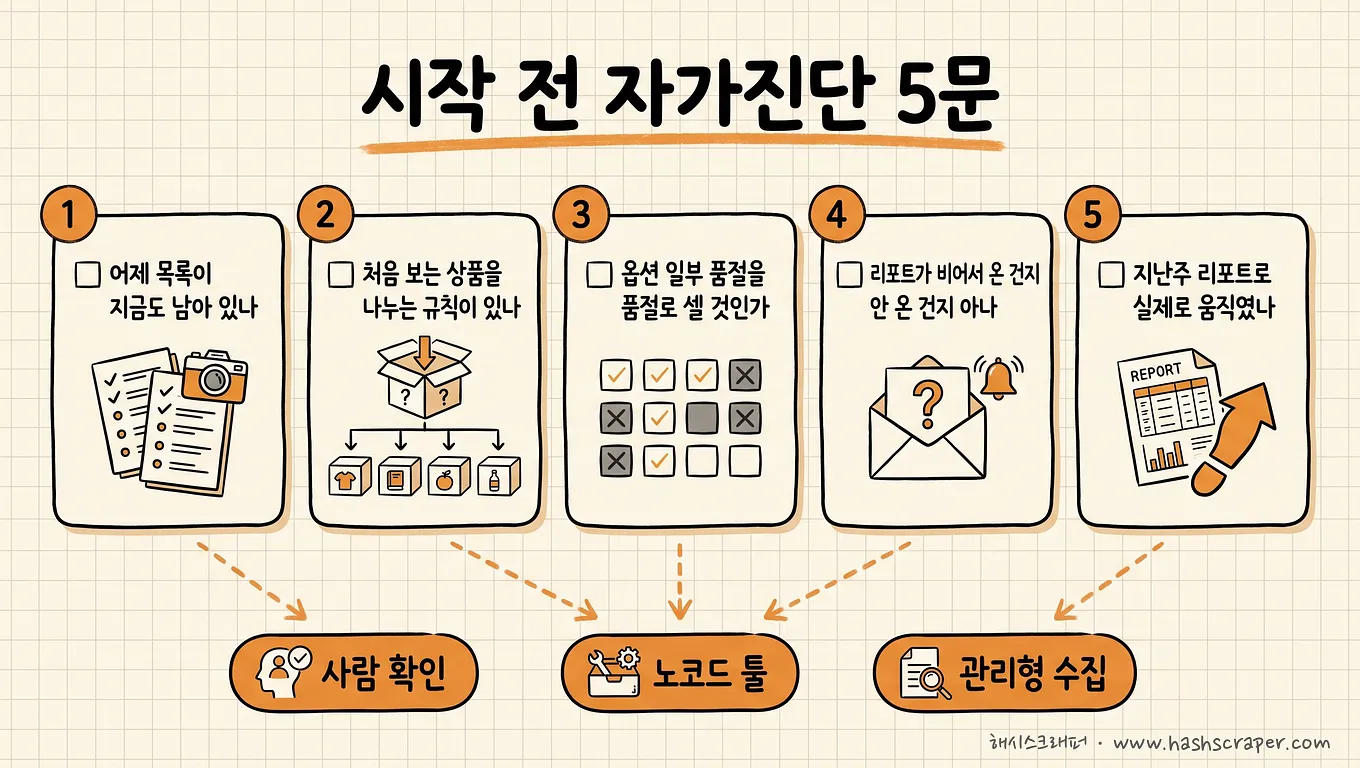
Prüfen Sie es. Diese fünf Zeilen sind schneller als drei Angebote.
- [ ] Ist die gestern erfasste Produktliste noch vorhanden — in einer Form, die sich Zeile für Zeile mit der heutigen Liste abgleichen lässt?
- [ ] Gibt es eine dokumentierte Regel, die „erstmals gesehenes Produkt“ in neues Produkt · Überarbeitung · zusätzliche Option · Wiedereinlagerung unterteilt?
- [ ] Kann das Team mit einem Satz beantworten, ob ein Produkt mit „nur teilweise ausverkauften Optionen“ als ausverkauft zählt?
- [ ] Kann der Empfänger an einem Tag, an dem die Erfassung fehlschlägt, unterscheiden, ob der Bericht leer eingetroffen ist oder gar nicht eingetroffen ist?
- [ ] Gab es aufgrund des Berichts der vergangenen Woche tatsächlich eine Handlung?
Wenn Punkt 1 mit „Nein“ beantwortet wird, ist es noch nicht an der Zeit, Tools zu vergleichen. Zuerst müssen ab heute Listen gespeichert werden.
Wenn Punkt 5 mit „Nein“ beantwortet wird, ist es kein Erfassungs-, sondern ein Schwellenwertproblem. Den Umfang einzugrenzen erzielt viel schneller Wirkung.
5 Schritte zur Einführung
Schritt 1. Grenzen Sie die Überwachungsziele ein — Nicht „alle Wettbewerber“, sondern zunächst „Wettbewerbsprodukte in Kategorien, auf die wir reagieren“. Je breiter der Umfang, desto breiter auch die Fehlalarme.
Schritt 2. Schreiben Sie Erkennungsregeln und Ausverkaufsdefinition auf eine Seite — Was ist der Identifikator, wie werden Überarbeitungen und neue Produkte unterschieden, wie werden ausverkaufte Optionen gezählt? Dieses eine Blatt ist das Anforderungsdokument.
Schritt 3. Erstellen Sie den Zeitplan durch Rückwärtsrechnung von der Zustellzeit — Platzieren Sie Erfassung, Wiederholungsversuche, Prüfung und Versand rückwärts. Entscheidend ist, die Felder für Prüfung und Wiederholungsversuche nicht leer zu lassen.
Schritt 4. Legen Sie Lieferformat und Schwellenwerte fest — Senden Sie die Daten per Excel, E-Mail, Slack oder API dorthin, wo die Verantwortlichen bereits arbeiten. Entscheidungskriterien je Format finden Sie unter Daten in Excel erhalten vs. Daten in einem Dashboard ansehen.
Schritt 5. Beseitigen Sie Fehlalarme in einem zweiwöchigen Pilotprojekt und erweitern Sie dann — In den ersten zwei Wochen werden die im Bericht aufgeführten neuen Produkte manuell abgeglichen. Dabei wird vollständig sichtbar, wo Fehlalarme entstehen, etwa wenn Überarbeitungen oder Wiedereinlagerungen als neue Produkte gezählt werden.
Die Aufgabe von heute ist nicht die Auswahl eines Anbieters. Es ist Schritt 2 — mit je einem Satz festzuhalten, was „neues Produkt“ und „ausverkauft“ für unser Team bedeuten.
Häufig gestellte Fragen
F. Ich möchte jeden Morgen automatisch Daten zu neuen Produkten und Ausverkaufsstatus der Wettbewerber erhalten. Wie gehe ich vor?
A. Es gibt drei Schritte. ① Den Zielumfang eingrenzen (welche Kategorie auf welcher Website), ② Erkennungsregeln definieren (was als neues Produkt und was als ausverkauft zählt) und ③ durch Rückwärtsrechnung von der Zustellzeit einen Zeitplan für Erfassung, Prüfung und Versand erstellen. Danach wird die Methode ausgewählt. Wenn es nur wenige Ziele gibt und intern jemand vorhanden ist, der Regeln bei Fehlern reparieren kann, können Sie mit der geplanten Ausführung von No-Code-Tools wie Octoparse oder Thunderbit beginnen (laut offiziellen Websites). Wenn die Anzahl der Ziele steigt oder der tägliche Morgenbericht geschäftskritisch ist, ist ein Managed Data Collection Service realistischer. Hashscraper plant und betreibt Snapshot-Speicherung, Erkennungsregeln und termingerechte Lieferung als Anforderungen.
F. Wie unterscheidet man zwischen einem neuen Produkt und einer Überarbeitung?
A. Dies lässt sich nicht zu 100 % automatisch unterscheiden. Es wird durch Regeln eingegrenzt — ob eine neue Produkt-ID erstellt wurde, ob die Ähnlichkeit des Produktnamens einen Schwellenwert überschreitet und ob das Produkt innerhalb der letzten N Tage in der Liste vorhanden war. In der Praxis ist es stabil, diese drei Signale zu kombinieren und in „neues Produkt / Überarbeitungskandidat / Wiedererscheinen“ zu unterteilen, während nur die Kandidatengruppe manuell geprüft wird.
F. Die Kennzeichnungen für Ausverkauf unterscheiden sich je nach Website. Lassen sie sich vereinheitlichen?
A. Es wird ein Wörterbuch der Kennzeichnungen je Website erstellt und in einen einheitlichen Statuswert normalisiert. Dabei ist es wichtig, die auf dem Bildschirm angezeigte Originalkennzeichnung mitzuspeichern. Denn auch bei einer Änderung der Formulierung auf der Website lassen sich historische Daten erneut klassifizieren.
F. Kann ich die Daten auch über Slack oder API statt über Excel erhalten?
A. Ja. Bei Hashscraper werden Excel-Dateien, automatischer E-Mail-Versand, API-Integration und direkte Datenbankbeladung unterstützt. Das Prinzip ist eines: Senden Sie die Daten dorthin, wo der Verantwortliche bereits arbeitet. Eine Struktur, bei der man etwas wissen kann, indem man es aktiv aufsucht, und eine Struktur, bei der man es beim Eintreffen weiß, unterscheiden sich in der Reaktionsgeschwindigkeit.
F. Wie häufig sollten Ausverkaufsdaten erfasst werden?
A. Richten Sie sich nach dem Reaktionszyklus. Wenn Entscheidungen in einer täglichen Morgenbesprechung getroffen werden, reicht einmal täglich aus. Bei Produktgruppen, deren Lagerbestand innerhalb eines Tages aufgebraucht sein kann, sollte ein kürzeres Intervall geplant werden; mit kürzeren Intervallen steigen jedoch zugleich Sperrrisiko und Kosten. Maßgeblich ist nicht die technische Grenze, sondern die Reaktionsgeschwindigkeit.
Fazit
Reduziert man das Design eines „täglichen Berichts über neue Produkte und Ausverkäufe am Morgen“, ergibt sich Folgendes.
- Die Liste von gestern speichern — Ohne Referenz-Snapshot lassen sich weder neue Produkte noch Ausverkäufe berechnen
- Definieren, was als neues Produkt und als ausverkauft zählt — Regeln zur Unterscheidung von Überarbeitungen, zusätzlichen Optionen und Wiedereinlagerungen
- Von der Zustellzeit rückwärts rechnen — Die Felder für Prüfung und Wiederholungsversuche nicht leer lassen
- Nur das lassen, was heute angesehen werden muss — Ein Bericht mit 200 Meldungen ist dasselbe wie ein Bericht mit 0 Meldungen
Preise werden gelesen, neue Produkte und Ausverkäufe werden gezählt.
Zum Zählen braucht man ein Lineal. Dasselbe Lineal wie gestern.
Sie brauchen nicht die heutige Produktliste. Sie brauchen die Differenz zwischen gestern und heute.
Eine Erfassung, die gestern nicht speichert, verpasst die neuen Produkte von heute für immer.
Jetzt direkt starten
Teilen Sie uns die zu überwachenden Wettbewerber, Kategorien und die gewünschte Zustellzeit mit. Wir prüfen kostenlos, ob die Erfassung möglich ist und wie sich die Erkennungsregeln für neue Produkte und Ausverkäufe definieren lassen. Bei einer Neuanmeldung erhalten Sie 50.000 Credits, sodass Sie zunächst die Qualität der Ergebnisse prüfen können.


