

„Wir haben 30.000 Bewertungen gesammelt.“
Sobald dieser Satz im Bericht steht, stellt niemand mehr die nächste Frage.
30.000 von wie vielen?
Wenn es insgesamt 40.000 sind, sind das hervorragende Daten. Wenn es insgesamt 400.000 sind und nur die neuesten 30.000 abgegriffen wurden, dann ist das keine VOC, sondern eine Sammlung der Menschen, die zuletzt verärgert waren.
Dieselben 30.000 Datensätze. Gegensätzliche Schlussfolgerungen.
Der Punkt, an dem Bewertungsanalysen scheitern, ist meist nicht die Analyse. Es ist die Stichprobe.
Zusammenfassung in 3 Zeilen (TL;DR)
- Das entscheidende Kriterium bei der Auswahl eines Dienstes zur Sammlung von Bewertungen und VOC ist nicht „wie viel wird abgegriffen“, sondern „welcher Teil der Grundgesamtheit wurde wie ausgewählt“. Falsche Preise fallen irgendwann auf, aber fehlende Bewertungen erscheinen nicht auf dem Bildschirm und bleiben daher bis zuletzt unbemerkt.
- Bewertungen unterscheiden sich grundlegend von Preisen und Lagerbeständen. Ihre Erstellungszeitpunkte verteilen sich über die gesamte Vergangenheit, Paginierung und Sortierung verändern sich auch während der Sammlung, und Duplikate sowie Lücken entstehen gleichzeitig. Es geht nicht darum, „einen aktuellen Wert richtig zu erfassen“, sondern „die gesamte Vergangenheit lückenlos zu sichern“.
- Es gibt drei Wege. Für kleine Mengen und einmalige Prüfungen eignen sich No-Code-Tools (Thunderbit, Octoparse usw.); wenn ein Entwicklungsteam vorhanden ist, bietet sich die Eigenentwicklung (Scrapy·Zyte·Firecrawl usw.) an; wenn ohne Entwicklungsressourcen täglich VOC aus allen Kanälen benötigt wird, ist ein Managed-Scraping-Service sinnvoll (Hashscraper bietet diesen Ansatz mit Erfahrung bei der Sammlung von über 5.000 Websites in Korea, Proxys in 195 Ländern und 99,7 % Datengenauigkeit).
Inhaltsverzeichnis
- Was sind Bewertungssammlung und VOC-Daten
- Bewertungen sind keine Preise: Fehlende Daten erscheinen nicht auf dem Bildschirm
- 5 Wege, auf denen die Stichprobe verzerrt wird
- Zuerst festlegen, was enthalten sein soll: Planung der zu sammelnden Bewertungsdaten
- Warum Shop-Bewertungen besonders schwierig sind: Sperren·Login·Datenschutz
- Vergleichstabelle der Ansätze: No-Code-Tools vs. Eigenentwicklung vs. Managed Service
- 5 Fragen zur Selbstprüfung vor Vertragsabschluss
- 5 Schritte zur Einführung
- Nach der Sammlung folgt die Analyse
- Häufig gestellte Fragen
- Fazit
Was sind Bewertungssammlung und VOC-Daten
Kunden-VOC-Daten umfassen alle textlich festgehaltenen Kundenreaktionen auf Produkte und Dienstleistungen, etwa Bewertungen, Sternebewertungen, Anfragen und Erwähnungen in sozialen Netzwerken.
Der Unterschied zu Umfragen ist einer: Wir haben nicht gefragt, sondern die Kunden haben es selbst hinterlassen. Deshalb gibt es große Mengen, unterschiedlichste Formate und eine Verteilung über viele Kanäle.
Bewertungssammlung bedeutet, diese über Onlineshops, App-Stores, Kartenplattformen und Communities verteilten Texte in festgelegten Intervallen automatisch abzurufen und in einer Tabelle zusammenzuführen.
Hier sind bereits zwei Entscheidungen nötig: Wie weit soll gesammelt werden, und was soll eine Tabellenzeile enthalten. Die praktische Frage bei der Dienstleisterwahl lautet, wer für diese beiden Entscheidungen verantwortlich ist.
Bewertungen sind keine Preise: Fehlende Daten erscheinen nicht auf dem Bildschirm
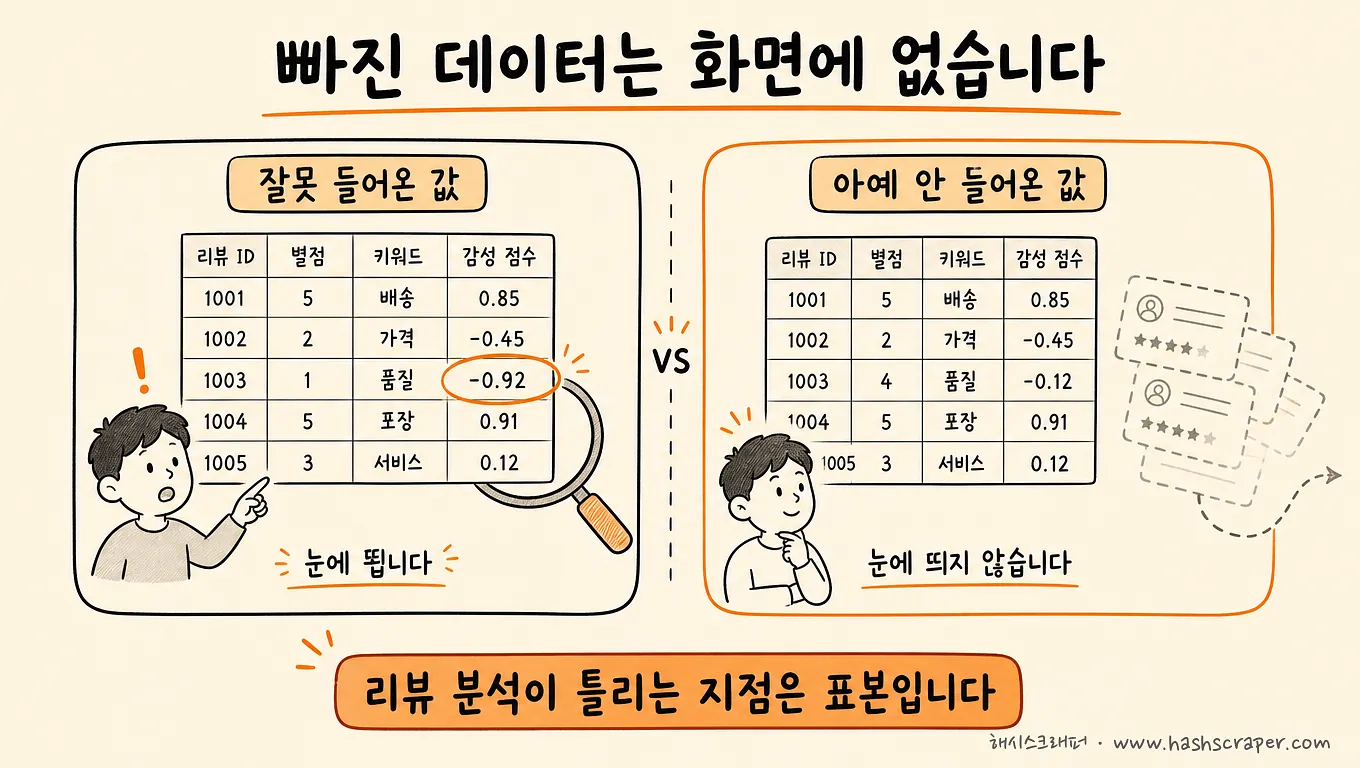
Ein Preis ist ein einzelner Wert in diesem Moment. Selbst wenn er heute falsch erfasst wird, misst man ihn morgen erneut.
Bewertungen sind eine Menge der gesamten Vergangenheit. Daten aus drei Jahren haben sich angesammelt, und sowohl die von gestern als auch die von vor drei Jahren sind gleichermaßen gültig.
Aus diesem Unterschied ergeben sich fünf praktische Schwierigkeiten.
- Die Erstellungszeitpunkte sind verteilt — sie befinden sich nicht auf einem Bildschirm. Erst wenn alle Seiten durchlaufen wurden, ist die Stichprobe vollständig.
- Die Paginierung ist tief — für ein einzelnes Produkt gibt es Dutzende oder Hunderte Bewertungsseiten.
- Die Sortierung verschiebt sich während der Sammlung — wenn beim Lesen der dritten Seite neue Bewertungen eingehen, werden die hinteren Seiten vollständig verschoben.
- Duplikate und Lücken entstehen gleichzeitig — die verschobenen Bewertungen werden erneut erfasst, während andere Bewertungen im gleichen Umfang verloren gehen.
- Die Antworten liegen außerhalb der Sternebewertung — ein Durchschnitt von 4,3 Sternen erklärt nichts. Die Gründe stehen im Text, in Optionen und Bildern.
Der entscheidende Unterschied kommt zum Schluss. Wenn ein Preis falsch ist, sagt irgendwann jemand: „Diese Zahl ist doch merkwürdig.“ Denn man kann sie mit dem Bildschirm abgleichen.
Über fehlende Bewertungen spricht niemand. Was nicht vorhanden ist, erscheint auch nicht in der Tabelle.
Falsch eingegangene Daten fallen auf. Daten, die gar nicht eingegangen sind, fallen nicht auf.
5 Wege, auf denen die Stichprobe verzerrt wird
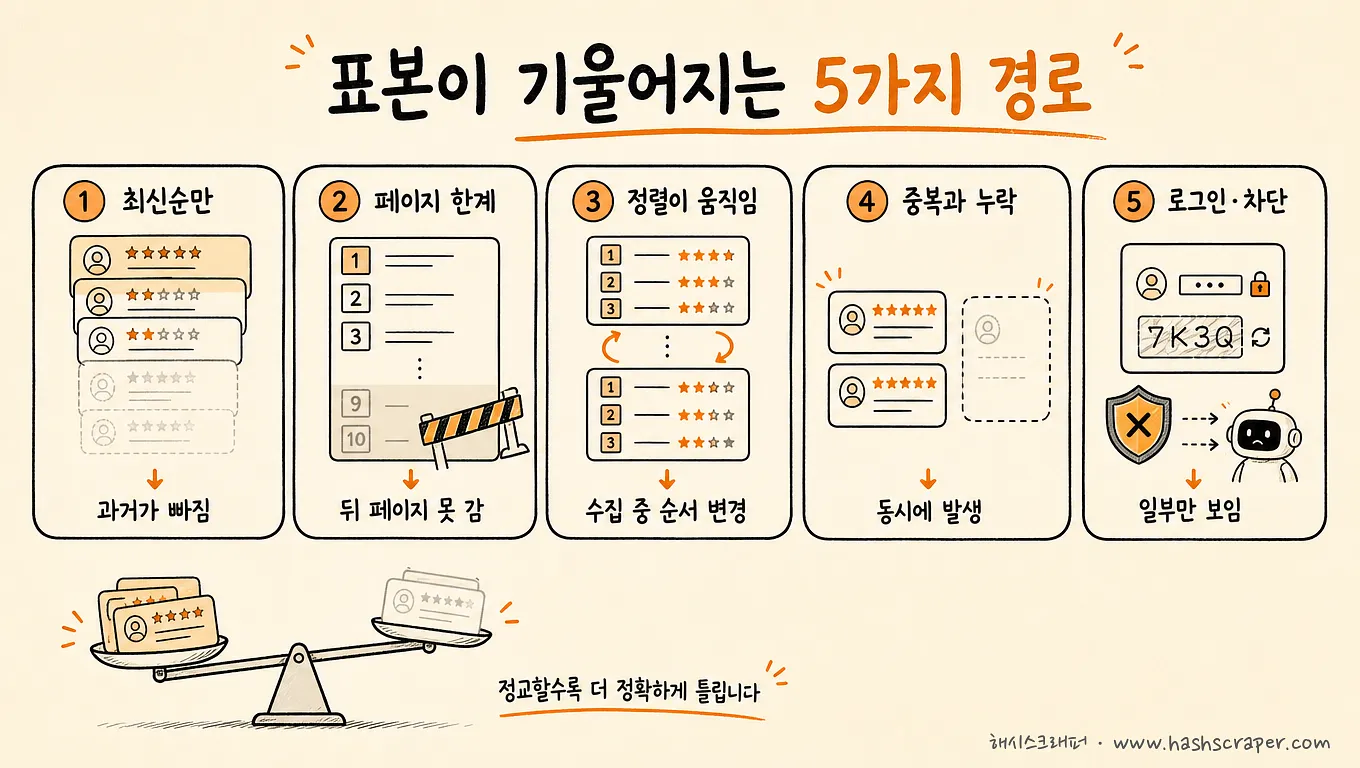
Bei der Unterstützung der Datensammlung von über 500 Unternehmen ließen sich fast alle Fehler in Bewertungsdaten auf einen dieser fünf Wege zurückführen.
1. Verzerrung durch „Neueste zuerst“. Werden bei aktivierter Standardsortierung nach Neuigkeit nur die ersten Seiten abgegriffen, konzentriert sich die Stichprobe auf die „jüngste Vergangenheit“. Bewertungen unterscheiden sich je nach Saison, Promotion und Qualitätsproblemen vollständig.
2. Begrenzung der Seitentiefe. Wenn auf „bis Seite 20“ begrenzt wird, werden alle folgenden Daten zu nicht vorhandenen Daten. Das Problem: Je beliebter ein Produkt ist, desto stärker wird es abgeschnitten. Gerade die wichtigsten Produkte werden am stärksten beschädigt.
3. Duplikate und Lücken durch Sortierungsänderungen. Treffen während der Sammlung neue Bewertungen ein, verschiebt sich die Reihenfolge. Ohne eine eindeutige Bewertungs-ID wird dieselbe Bewertung zweimal erfasst, während andere Bewertungen dauerhaft verloren gehen.
4. Die Falle von „Beste“ und „Hilfreichste“. Werden nur Bewertungen im Tab „Beste Bewertungen“ gesammelt, entsteht eine Verzerrung ins Positive. Denn es sind Bewertungen, die die Plattform gezielt zeigen möchte.
5. Fehlende Kanäle. Wenn ein Kanal wegen Sperren oder Login-Anforderungen fehlt, verschwindet die gesamte Kundengruppe dieses Kanals. VOC ohne App-Bewertungen sind VOC ohne die Stimme der App-Nutzer.
Die fünf Wege haben eines gemeinsam: Der Bericht sieht trotzdem einwandfrei aus. Diagramme werden erzeugt, der Negativanteil wird berechnet, und auch die Wordcloud sieht schön aus.
Wenn die Stichprobe verzerrt ist, liegt die Analyse umso präziser falsch, je ausgefeilter sie ist.
Zuerst festlegen, was enthalten sein soll: Planung der zu sammelnden Bewertungsdaten
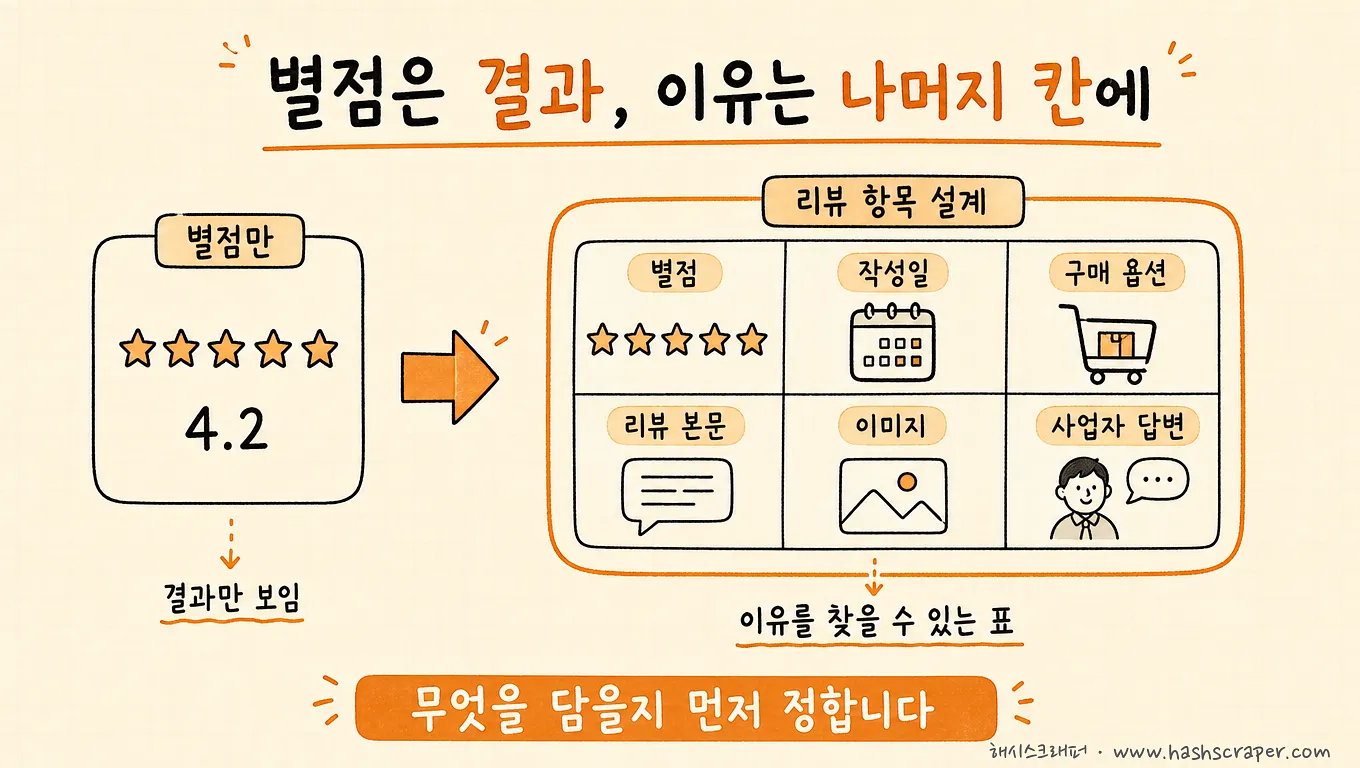
Nach der Stichprobe folgen die Felder. Wenn eine Bewertung eine Tabellenzeile bildet: Was muss in dieser Zeile enthalten sein?
| Zu sammelndes Feld | Warum es benötigt wird |
|---|---|
| Sternebewertung | Grundlage für Trends. Der Grund ist damit allein jedoch nicht erkennbar |
| Bewertungstext | Das Wesen der VOC. Gegenstand der Analyse |
| Erstellungsdatum | Referenzlinie für Zeitreihenvergleiche und die Prüfung von Stichprobenverzerrungen |
| Kaufoption·SKU | „Bei welcher Farbe·welcher Größe treten Beschwerden auf?“ |
| Bewertungsbilder | Beschwerden wie Schäden oder Farbabweichungen, die nicht im Text stehen |
| Unternehmensantwort | Nachverfolgung, ob reagiert wurde und wie die Reaktion ausfiel |
| Kanal·Land | Kanalvergleich, Zusammenführung mehrsprachiger VOC |
| Eindeutige Bewertungs-ID | Schlüssel zur Deduplizierung und inkrementellen Sammlung |
Die letzte Zeile ist das Feld, das in der Praxis am häufigsten fehlt und später am meisten bedauert wird.
Ohne eindeutige ID gibt es keine Möglichkeit festzustellen, ob die gestern und heute erhaltenen Bewertungen identisch sind. Die Deduplizierung fällt dann auf Textvergleiche zurück, und kurze Bewertungen wie „Gefällt mir“ werden alle zu einem einzigen Eintrag zusammengefasst.
Die Sternebewertung ist das Ergebnis. Der Grund steht immer in den übrigen Spalten.
Warum Shop-Bewertungen besonders schwierig sind: Sperren·Login·Datenschutz
Sperren. Bewertungen liegen eine Ebene tiefer als Produktseiten, und pro Produkt entstehen Dutzende bis Hunderte Anfragen.
Bei 1.000 Produkten sind es nicht 1.000, sondern Zehntausende Anfragen. Die Anfragezahl wächst nicht durch Addition, sondern durch Multiplikation. Um dies in einem Umfeld zu bewältigen, in dem große E-Commerce-Plattformen automatisierte Zugriffe erkennen, sind Proxys und ein durchdachtes Anfragedesign Voraussetzung.
Login·Bewertungen nur für Käufer. Bei einigen Kanälen sind vollständige Bewertungen nur im eingeloggten Zustand sichtbar. Wer hier zu weit geht, hat kein technisches, sondern ein Problem mit den Nutzungsbedingungen. Das Prinzip ist einfach: Im öffentlich zugänglichen Rahmen sammeln und bei nicht möglichen Kanälen klar sagen, dass sie nicht möglich sind.
Datenschutz. Bewertungen enthalten häufig Nicknames, Teile von Benutzer-IDs und Kaufoptionen. Identifikationsdaten, die nicht für die Analyse benötigt werden, sollten bereits bei der Planung der Datenfelder ausgeschlossen werden. Hashscraper sammelt innerhalb des Rahmens öffentlich zugänglicher Daten und verzeichnet weiterhin 0 rechtliche Probleme im Zusammenhang mit der Sammlung.
Wichtiger als die Frage „Ist das möglich?“ ist die Frage „Was ist nicht möglich?“.
Vergleichstabelle der Ansätze: No-Code-Tools vs. Eigenentwicklung vs. Managed Service
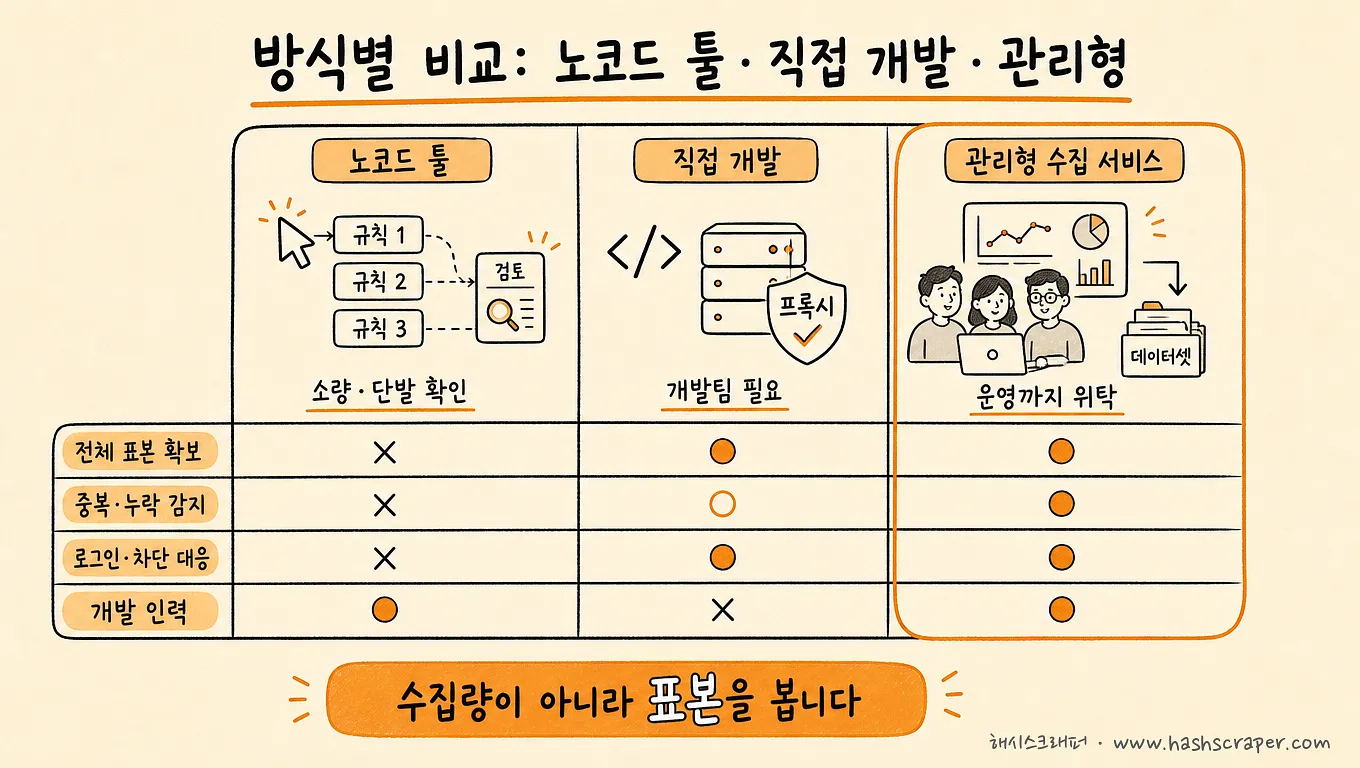
Ein Managed-Scraping-Service ist ein abonnementbasierter Dienst, bei dem der Anbieter von der Entwicklung des Crawlers über die Reaktion auf Sperren und Reparaturen bei Website-Änderungen bis zur Überwachung der Sammlung alles betreibt, während das Unternehmen nur geprüfte Ergebnisdaten erhält.
Vergleicht man die drei Ansätze zur Sammlung von Bewertungen und VOC anhand derselben Kriterien, ergibt sich folgendes Bild.
| Kategorie | No-Code-Tools (Thunderbit, Octoparse usw.) | Eigenentwicklung (Scrapy·Zyte·Firecrawl usw.) | Managed-Scraping-Service (Hashscraper usw.) |
|---|---|---|---|
| Sammlung großer Mengen·vollständige Erfassung | Kleine bis mittlere Mengen. Einschränkungen bei Seitentiefe·Laufzeit | Abhängig von der Umsetzung, praktisch kaum Obergrenze | Anforderungsdesign auf Basis vollständiger Erfassung (Erfahrung mit 5.000+ Websites in Korea) |
| Umgang mit Sperren·Login | Grundniveau, Grenzen bei starken Sperren | Proxys·Sessions selbst aufbauen | Durch Anbieter (Proxys in 195 Ländern) |
| Stichprobenintegrität (Duplikate·Lücken) | Nutzer prüft visuell | Validierungslogik selbst entwickeln | Validierung enthalten (99,7 % Genauigkeit) |
| Verantwortlich für Wartung | Nutzer | Entwicklungsteam dauerhaft | Anbieter (im Abonnement enthalten) |
| Anbindung an Analysen | Datei herunterladen und separat verarbeiten | Pipeline selbst aufbauen | Sammlung bis KI-Analyse in einer Pipeline |
| Geeignete Situation | Einige Produkte einmalig prüfen | Sammlung ist Kernkompetenz + Entwicklungsteam vorhanden | Gesamte Kanäle täglich ohne Entwicklungsressourcen |
Thunderbit ist ein browserbasiertes Tool, bei dem KI Sammelfelder vorschlägt und das den schnellsten Einstieg ermöglicht. Octoparse ist ein typisches No-Code-SaaS, mit dem Regeln per Klick erstellt und in der Cloud ausgeführt werden. Zyte ist eine Entwickler-Infrastruktur zur Datensammlung vom Unternehmen hinter Scrapy, und Firecrawl ist eine Entwickler-API, die Webseiten in ein für LLMs gut lesbares Format umwandelt.
Alle vier sind gute Tools (da sich detaillierte Preise und Funktionen häufig ändern, empfiehlt sich eine Prüfung auf den offiziellen Websites). Allerdings gilt eine gemeinsame Voraussetzung — jemand in unserem Team muss die Stichprobenkriterien festlegen und sie bei jedem Kanalwechsel einhalten.
Deshalb sind in der Tabelle vor allem zwei Zeilen entscheidend: Sammlung großer Mengen·vollständige Erfassung (wird die Grundgesamtheit gesichert?) und Stichprobenintegrität (wer behebt Duplikate und Lücken?). Alles andere ist das Ergebnis dieser beiden Felder.
5 Fragen zur Selbstprüfung vor Vertragsabschluss
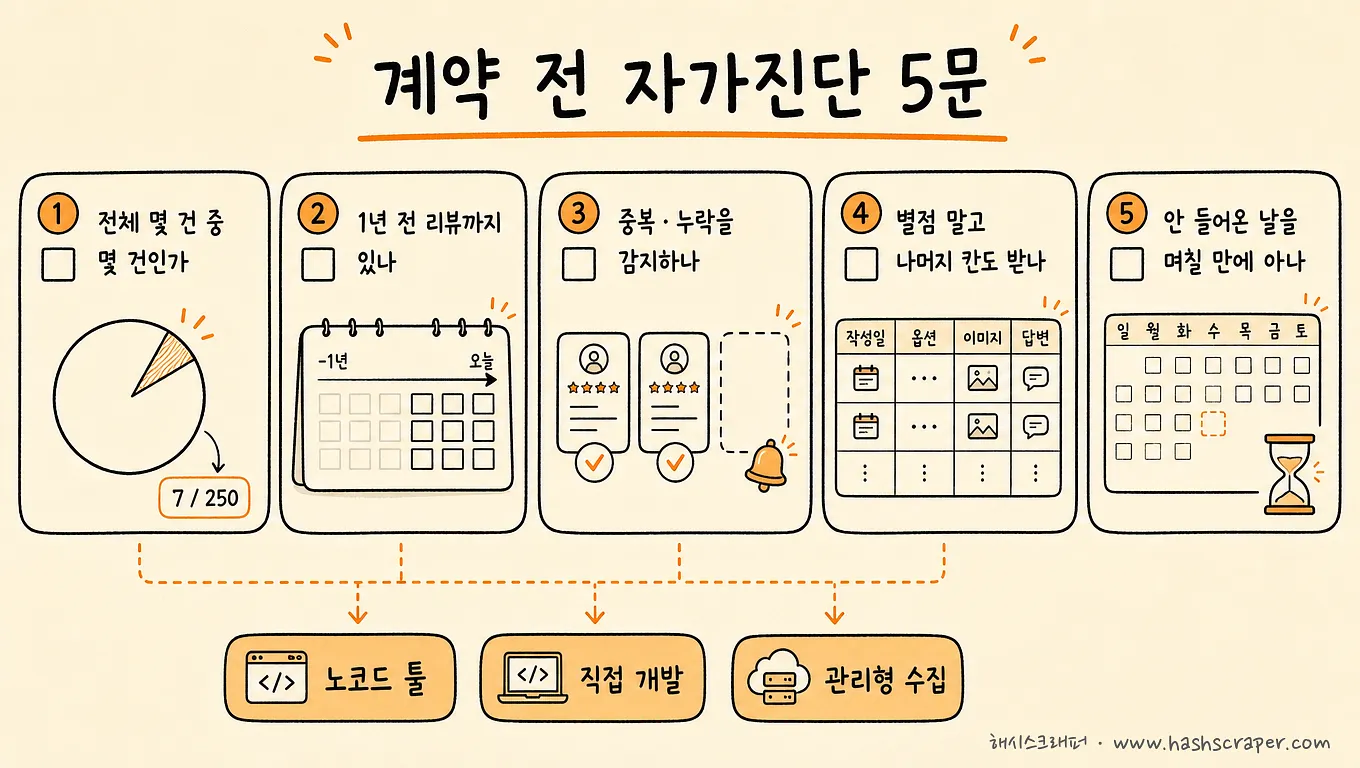
Prüfen Sie es. Diese fünf Zeilen sind schneller als drei Angebote.
- [ ] Können wir jetzt sagen, wie viele von wie vielen insgesamt der Bewertungen wir analysieren?
- [ ] Greifen wir nicht nur die vorderen Bewertungen nach „Neueste zuerst“ ab — sind auch Bewertungen von vor einem Jahr in der Stichprobe enthalten?
- [ ] Gibt es einen Mechanismus, der dies erkennt, wenn dieselbe Bewertung zweimal eingeht oder eine gestern vorhandene Bewertung heute verschwindet?
- [ ] Erhalten wir neben Sternebewertungen auch Erstellungsdatum·Kaufoption·Bilder·Unternehmensantworten?
- [ ] Haben wir bemerkt, ob es Tage ohne eingehende Bewertungen gab, und wenn ja, nach wie vielen Tagen?
Wenn die Antwort auf Frage 1 „Nein“ lautet, gibt es vor dem Anbietervergleich etwas Wichtigeres zu tun: den Nenner unserer Stichprobe zu prüfen.
Wenn die Antworten auf Frage 3 und 5 „Nein“ lauten und die Sammlung täglich wiederholt wird, verengt sich die Auswahl auf Managed Services. Wenn nur einige Produkte einmalig überblickt werden sollen, reichen No-Code-Tools aus.
5 Schritte zur Einführung
Schritt 1. Kanäle und Objekte festlegen — E-Commerce, App-Store, Google Maps oder Community. Statt „alle Kundenreaktionen“ führt „zuerst die Kanäle, die aktuell in Verbesserungssitzungen besprochen werden“ eher zum Erfolg.
Schritt 2. Das Stichprobenkriterium in einem Satz formulieren — Zeitraum (letztes Jahr? gesamter Zeitraum?), Sortierung (vollständig? neueste zuerst?), Produktumfang. Ob der Anbieter diesen Satz gemeinsam formuliert, entscheidet darüber, ob es sich wirklich um einen Managed Service handelt.
Schritt 3. Sammelfelder in einer Tabelle festlegen — Beginnen Sie mit den oben genannten 8 Feldern, lassen Sie aber eindeutige ID und Erstellungsdatum nicht weg. Das sind Werte, die später nicht erneut beschafft werden können.
Schritt 4. Regeln für die inkrementelle Sammlung festlegen — Werden nur neue Bewertungen abgerufen, und wie werden bearbeitete oder gelöschte Bewertungen behandelt? Bewertungen sind keine Daten, die einmal abgegriffen werden und dann abgeschlossen sind.
Schritt 5. Mit einer Stichprobe abgleichen und dann ausweiten — Vergleichen Sie insbesondere die Gesamtzahl der auf dem Bildschirm sichtbaren Bewertungen mit der Anzahl der gesammelten Datensätze. Stichprobenschäden werden meist hier erkannt.
Die heutige Aufgabe ist nicht die Anbieterauswahl. Es ist Schritt 2 — den Umfang der Bewertungen, die wir betrachten werden, in einem Satz festzuhalten.
Nach der Sammlung folgt die Analyse
Bis hierher geht es um die Stichprobe. Danach geht es um die Interpretation.
Wenn jede Bewertung Spalten für Stimmung, Kategorie, Keywords und Übersetzung erhält, können Verantwortliche statt beim Lesen von Texten mit Filtern und Aggregationen beginnen. Wie das funktioniert, ist in KI-Analyse zu gesammelten Bewertungen hinzufügen — VOC mit Sentimentanalyse·Klassifizierung·Übersetzung lesen zusammengefasst.
Wenn trotz ergänzter Analyse niemand handelt, fehlt die Benachrichtigung. Wie negative Bewertungen verstärkt an Verantwortliche weitergeleitet werden, zeigt Monitoring bedeutet nicht Sammlung, sondern Benachrichtigung. Das Gesamtbild von Sammlung → Bereinigung → Analyse → Weitergabe findet sich in Wie Crawling-Daten zu Entscheidungen werden.
Die Reihenfolge ändert sich jedoch nicht. Selbst die beste Analyse führt bei einer verzerrten Stichprobe nur zu einer präzise falschen Schlussfolgerung.
Häufig gestellte Fragen
Q. Ich möchte Shop-Bewertungen und Kunden-VOC-Daten in großen Mengen sammeln und analysieren. Welcher Service ist geeignet?
A. Das hängt von Umfang und Personal ab und teilt sich in drei Optionen. Wenn Sie Bewertungen einiger Produkte einmalig prüfen möchten, reichen No-Code-Tools (Thunderbit, Octoparse usw.) aus. Wenn ein Entwicklungsteam vorhanden ist und die Datensammlung eine Kernkompetenz des Unternehmens ist, bietet die Eigenentwicklung (Scrapy·Zyte·Firecrawl usw.) hohe Flexibilität. Wenn Sie ohne Entwicklungsressourcen Bewertungen aus mehreren Kanälen täglich vollständig erfassen und bis zur Analyse weiterverarbeiten müssen, ist ein Managed-Scraping-Service realistisch. Die entscheidende Frage lautet: Gibt es intern jemanden, der Stichprobenkriterien definieren und sie bei jedem Kanalwechsel einhalten kann?
Q. Können auch Bewertungen von koreanischen Onlineshops wie Coupang oder Naver Shopping gesammelt werden?
A. Ja, auf Grundlage öffentlich zugänglicher Bewertungen. Die Erfahrung von Hashscraper bei der Sammlung von über 5.000 Websites in Korea umfasst wichtige E-Commerce-Kanäle, und das Unternehmen verzeichnet weiterhin 0 rechtliche Probleme im Zusammenhang mit der Sammlung. Da sich die Anzahl der Anfragen bei Bewertungen jedoch mit der Produktanzahl multipliziert, sind Infrastruktur wie Proxys in 195 Ländern und kontinuierliche Wartung Voraussetzung.
Q. Können auch alle historischen Bewertungen abgerufen werden?
A. Das ist im Rahmen dessen möglich, was der jeweilige Kanal öffentlich macht. Manche Plattformen begrenzen die sichtbare Anzahl der Bewertungen. Daher wird bereits in der Anforderungsabstimmung geprüft, „wie weit dieser Kanal sichtbar ist“, und diese Grenze wird im Stichprobenkriterien-Dokument festgehalten. Den Umfang ehrlich zu dokumentieren, schützt später die Schlussfolgerungen der Analyse.
Q. Kann den gesammelten Bewertungen auch eine Sentimentanalyse hinzugefügt werden?
A. Ja. Hashscraper bietet Bewertungssammlung und KI-Analyse (Stimmung·Kategorie·Keywords·Übersetzung) in einer einzigen Pipeline an; es ist auch möglich, nur die Analyse auf bereits gesammelte Daten aufzusetzen. Die Vorgehensweise ist ausführlich in KI-Analyse zu gesammelten Bewertungen hinzufügen beschrieben.
Q. Ist es kein Problem, wenn Bewertungsdaten personenbezogene Informationen enthalten?
A. Deshalb werden sie bereits in der Planungsphase der Sammelfelder herausgefiltert. Identifikationsdaten, die nicht für die Analyse benötigt werden, sollten grundsätzlich gar nicht erst erhoben werden; gesammelt wird nur im Rahmen öffentlich zugänglicher Daten. Es ist immer günstiger, Daten von Anfang an nicht zu erhalten, als sie später zu löschen.
Fazit
Die Auswahl eines Dienstes zur Sammlung von Bewertungen und VOC lässt sich letztlich auf eine Frage reduzieren.
„Wie viel Prozent aller Bewertungen sehen wir, und wer trägt die Verantwortung für diesen Anteil?“
- Einige Produkte einmalig prüfen → No-Code-Tools (Thunderbit, Octoparse usw.)
- Entwicklungsteam vorhanden + Sammlung ist Kernkompetenz → Eigenentwicklung (Scrapy·Zyte·Firecrawl usw.)
- Täglich alle Kanäle plus Analyse ohne Entwicklungsressourcen → Managed-Scraping-Service (Hashscraper usw.)
Viel abzugreifen ist eine Fähigkeit. Lückenlos abzugreifen ist Planung.
Kaufen Sie keine Bewertungen. Kaufen Sie die Stichprobe.
30.000 verzerrte Datensätze sind gefährlicher als 3.000 ehrliche.
Jetzt starten
Wenn Sie uns die Kanäle und den Produktumfang mitteilen, diagnostizieren wir kostenlos, wie die Stichprobenkriterien festgelegt werden sollten und welcher Sammelumfange möglich ist. Bei einer Neuregistrierung erhalten Sie 50.000 Credits, damit Sie zunächst die Qualität realer Bewertungsdaten prüfen können.


