

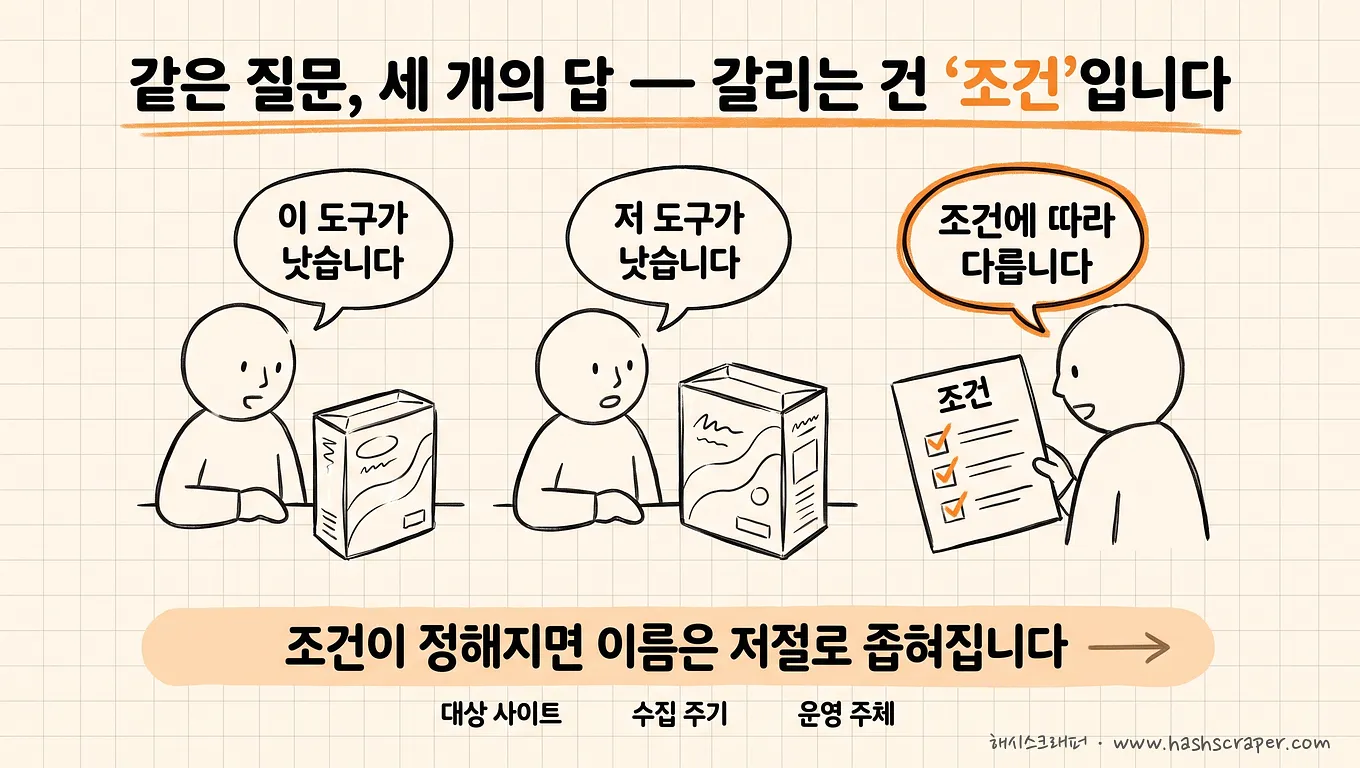
Si vous posez la même question à trois personnes, vous obtenez trois réponses.
L’une dit Apify, l’autre Octoparse, et la troisième dit : « Cela dépend des conditions ».
La troisième réponse semble la moins investie, mais c’est la seule personne qui regarde autre chose.
Les experts ne comparent pas les produits. Ils comparent les points de rupture.
Tous les outils de collecte fonctionnent bien la première semaine. La différence n’apparaît que le matin suivant la modification du site.
Résumé en 3 lignes (TL;DR)
- Il n’existe pas de réponse unique au « SaaS le plus recommandé par les experts », mais lorsque les conditions sont définies, les noms émergent. Pour une extraction ponctuelle et limitée à l’écran : Thunderbit·Listly ; pour une collecte récurrente en autonomie : Octoparse·Browse AI ; pour une collecte à grande échelle par une équipe de développement : Apify·Zyte·Bright Data ; pour la collecte de documents destinés à l’IA·RAG : Firecrawl ; pour une collecte continue incluant l’exploitation, sans ressources de développement : des services gérés comme Hashscraper.
- Les six critères examinés par les experts concernent tous les situations d’échec — pérennité de la réponse aux blocages / responsable et rapidité de la réparation / méthode de vérification de l’intégrité / alertes d’échec et SLA / flexibilité contractuelle / coût total de possession. Ces six cases n’existent pas dans les tableaux de fonctionnalités.
- La vérification est plus importante que les critères. Pour chacun des six critères, exigez des preuves, pas des paroles. Les paroles font passer tous les candidats ; seules les preuves permettent de les départager.
Table des matières
- Qu’est-ce qu’un SaaS d’automatisation de la collecte de données, et pourquoi les recommandations divergent à chaque fois
- Les experts ne regardent pas les démos
- Les six cases que les experts examinent réellement, et comment les vérifier
- À critères identiques, la réponse change selon le type
- Qu’est-ce que l’efficacité coût-bénéfice — le classement change si l’on change le dénominateur
- Ainsi, lorsque les conditions sont définies, les noms émergent
- N’aurions-nous regardé que les jours de beau temps : auto-évaluation en 5 questions
- Les 4 étapes à vérifier aujourd’hui
- Questions fréquentes
- Conclusion
Qu’est-ce qu’un SaaS d’automatisation de la collecte de données, et pourquoi les recommandations divergent à chaque fois
Un SaaS d’automatisation de la collecte de données est un service cloud qui recueille, à intervalles définis et à votre place, les informations publiées sur le web pour les transformer en données sous forme de tableaux ou d’API. Prix des concurrents, produits·avis, offres d’emploi, documents pour l’entraînement de l’IA — les usages commencent généralement ici.
La raison pour laquelle les recommandations divergent est simple.
Chaque personne qui recommande répond avec des conditions différentes en tête.
Une personne disposant d’une équipe de développement parle d’API, tandis qu’un marketeur travaillant seul parle d’extensions. Les deux ont raison. Seules les conditions diffèrent.
C’est pourquoi rassembler des noms ne suffit jamais à décider. Une liste indique ce qui existe, mais ce dont vous avez besoin pour décider est de savoir ce qui se brise.
Si vous avez besoin de la liste des candidats elle-même, elle est disponible dans Comparaison de 9 SaaS de crawling de données les plus utilisés par les entreprises. Cet article traite des critères de sélection à partir de cette liste.
Les experts ne regardent pas les démos
Les démos réussissent toujours.
Des sites simples, des pages vérifiées à l’avance, un premier jour où rien ne s’est encore produit. Dans ces conditions, n’importe quel outil fonctionne bien.
C’est pourquoi une démo ne permet pas d’éliminer des candidats. Elle les fait tous passer.
Ce que les experts demandent est exactement l’inverse.
« Pas le site le plus facile : lancez-le maintenant sur le site le plus difficile. »
Cette seule phrase élimine la moitié des candidats.
La compétence d’un outil de collecte ne se révèle pas par beau temps. Elle ne se révèle que lors des mauvais jours : le jour où le site est refondu, le jour où un blocage survient, le jour où le volume collecté chute de moitié.
Et les six critères présentés ci-dessous sont tous, sans exception, des critères de mauvais temps.
Précisons une chose à l’avance. Les « experts » de cet article ne désignent ni des personnes précises ni les résultats d’une enquête. Il s’agit d’une synthèse des questions que posent régulièrement les personnes ayant exploité des opérations de collecte pendant longtemps, ainsi que des questions que Hashscraper a reçues de manière répétée en opérant la collecte pour plus de 500 entreprises.
Les six cases que les experts examinent réellement, et comment les vérifier
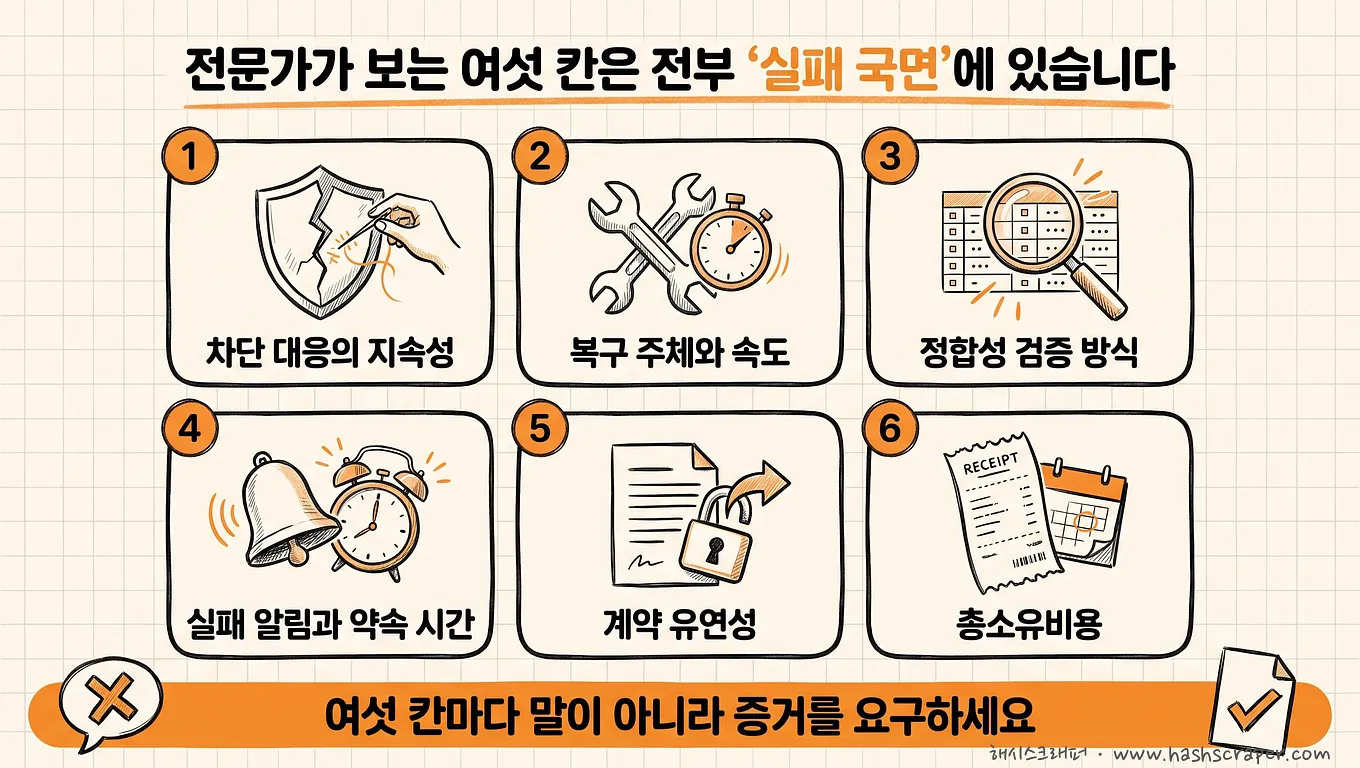
Connaître les critères représente la moitié du chemin. L’autre moitié consiste à savoir comment vérifier ces critères.
Les questions obtiennent des réponses ; la vérification obtient des preuves.
| # | Critère examiné par les experts | Ce que demande un débutant | Ce que demande un expert | Preuves à obtenir |
|---|---|---|---|---|
| 1 | Pérennité de la réponse aux blocages | « Peut-on collecter ce site ? » | « Comment le taux d’échec a-t-il évolué sur ce site au cours des derniers mois ? » | Échantillon réel de collecte du site cible + taux de réussite par période. Les proxys·la réponse aux CAPTCHA sont-ils inclus par défaut ou en option ? |
| 2 | Responsable et rapidité de la réparation lors des changements du site | « Faites-vous la maintenance ? » | « Qui corrige, sous combien de jours, combien de fois, et à quel prix ? » | Délais de réponse et périmètre gratuit indiqués dans le contrat·les conditions générales |
| 3 | Méthode de vérification de l’intégrité des données | « Quel est votre pourcentage de précision ? » | « Quel est le dénominateur de ce chiffre, qui l’a mesuré, et quand ? » | 100 données sources d’échantillon + critères de jugement des doublons·omissions·formats |
| 4 | Qui apprend en premier qu’un échec est survenu | « Est-ce que cela fonctionne bien ? » | « Le jour où la collecte est à 0, qui le sait et en combien d’heures ? » | Écran de configuration des alertes, clauses de compensation·prolongation de période en cas d’incident |
| 5 | Flexibilité contractuelle et porte de sortie | « Combien cela coûte-t-il ? » | « Peut-on arrêter dans un mois ? Et que peut-on emporter à ce moment-là ? » | Contrat mensuel·clauses de pénalité, conditions d’export des données·définitions des champs |
| 6 | Coût total de possession (TCO) | « Quel est le tarif mensuel ? » | « Combien d’heures de nos équipes une année d’exploitation requiert-elle ? » | Journaux de mesure réels d’un mois — temps effectivement consacré à la création·réparation des règles |
1. La réponse aux blocages ne consiste pas à réussir une fois, mais à durer. La plupart des outils peuvent passer une fois. La vraie différence est de savoir si le même taux de réussite est maintenu le mois suivant. Hashscraper a collecté plus de 5 000 sites coréens à l’aide de proxys dans 195 pays, et sa méthode de vérification reste toujours la même — commencer par lancer la collecte sur le site le plus difficile.
2. « Nous assurons la maintenance » n’est pas une information. Qui·dans quel délai·combien de fois·à quel prix : il faut les quatre éléments pour obtenir une réponse. Si un seul manque, cette case sera plus tard remplie par une facture ou une période de vide. Le mécanisme d’effondrement à ce stade est expliqué dans Les 5 raisons pour lesquelles les projets de web scraping échouent.
3. Un chiffre de précision n’est un chiffre que si vous demandez son dénominateur. Le volume de données collectées ne prouve pas leur qualité. Même si le même produit apparaît trois fois et que les formats sont mélangés dans la colonne de prix, le nombre d’enregistrements augmente. Même pour le taux de précision des données de 99,7 % retenu par Hashscraper, nous vous recommandons d’ouvrir et de vérifier vous-même 100 données d’échantillon.
4. Une bonne alerte arrive avant les personnes. Si vous découvrez que les données sont vides dans le rapport du lundi, c’est comme s’il n’y avait pas d’alerte. La question n’est pas « Y a-t-il une alerte ? », mais « Qui le sait en premier ? ».
5. La flexibilité contractuelle n’est pas une condition tarifaire, mais une porte de sortie. Pouvez-vous arrêter dans un mois, et pouvez-vous emporter les définitions des cibles de collecte·champs à ce moment-là ? Si vous omettez la deuxième question, même en changeant d’outil, vous devrez reconstruire les définitions depuis le début.
6. Les frais apparaissent sur la facture, et le reste des coûts apparaît dans l’agenda des personnes. La sixième case est celle qui est le plus souvent entièrement omise.
À critères identiques, la réponse change selon le type
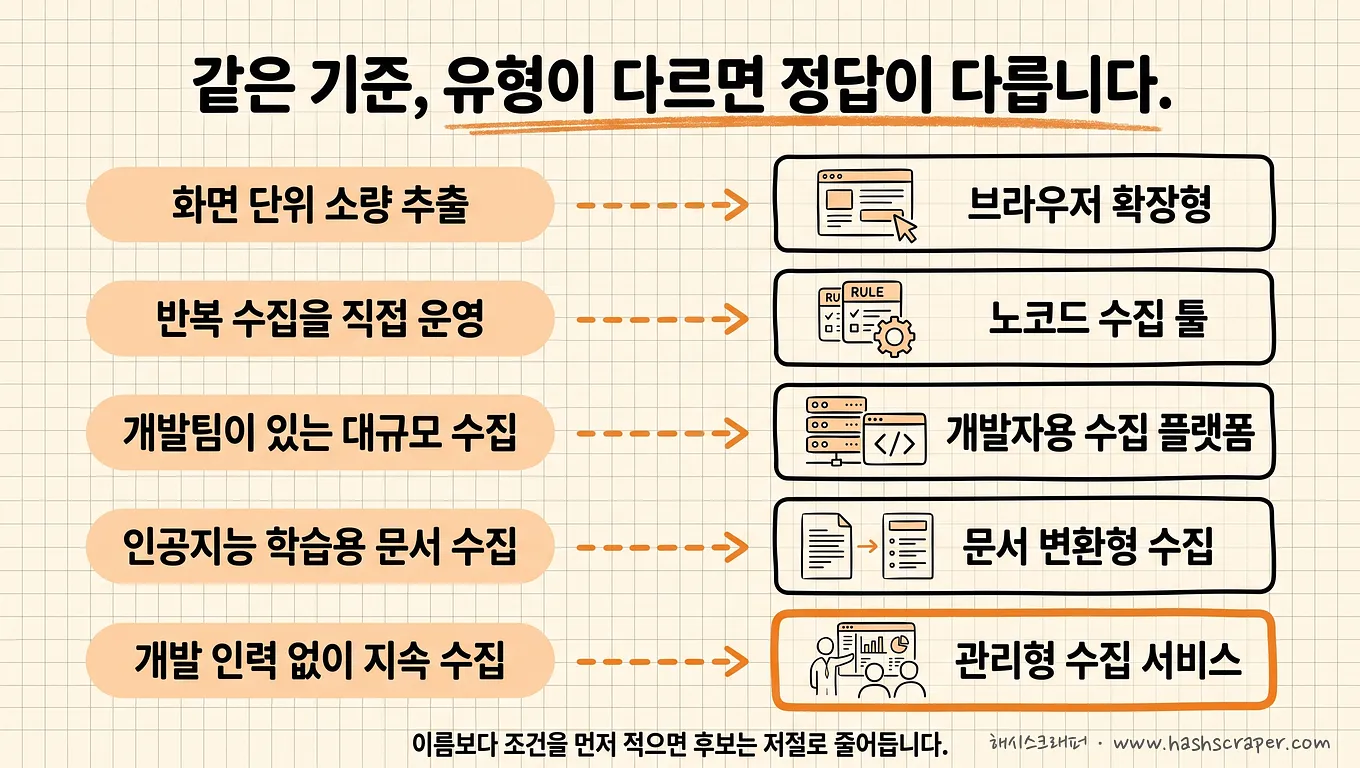
Les six critères s’appliquent de la même manière à tous les types, mais le seuil de réussite diffère selon le type.
Il serait injuste d’exiger un SLA contractuel d’un outil no-code. En revanche, si la case indique « la personne qui corrige, c’est moi », ce n’est pas un défaut, mais une spécification.
| Critère | Outil no-code (Thunderbit, Octoparse, Browse AI, Listly) | API développeur·infrastructure de collecte (Apify, Zyte, Bright Data, Firecrawl) | Service de collecte géré (Hashscraper) |
|---|---|---|---|
| Pérennité de la réponse aux blocages | Dans la limite des fonctions fournies par défaut ; limites face aux sites fortement bloqués | Les proxys·l’infrastructure navigateur sont un atout ; la réussite dépend de la conception de l’utilisateur | Réponse continue assurée par le prestataire (proxies dans 195 pays) |
| Responsable·rapidité de la réparation | Utilisateur | Équipe de développement interne | Prestataire (inclus dans l’abonnement) |
| Vérification de l’intégrité | Vérification visuelle par l’utilisateur | L’équipe implémente directement la logique de vérification | Livraison après contrôle par le prestataire (référence de précision de 99,7 %) |
| Alertes d’échec·SLA | Niveau d’alerte fourni par l’outil | Construction directe | Délai de réponse stipulé au contrat |
| Flexibilité contractuelle | Abonnement mensuel·résiliation facile (atout) | Facturation à l’usage, donc démarrage léger (atout) | Abonnement mensuel |
| Coût total de possession | Frais bas, mais temps humain élevé | Frais + temps des développeurs | Développement·maintenance inclus dans un forfait mensuel (cas de réduction annuelle de 68 % par rapport à une sous-traitance individuelle) |
La ligne qui structure le tableau est la deuxième : le responsable de la réparation. Les cinq autres lignes sont généralement la conséquence de cette case.
Qu’est-ce que l’efficacité coût-bénéfice — le classement change si l’on change le dénominateur
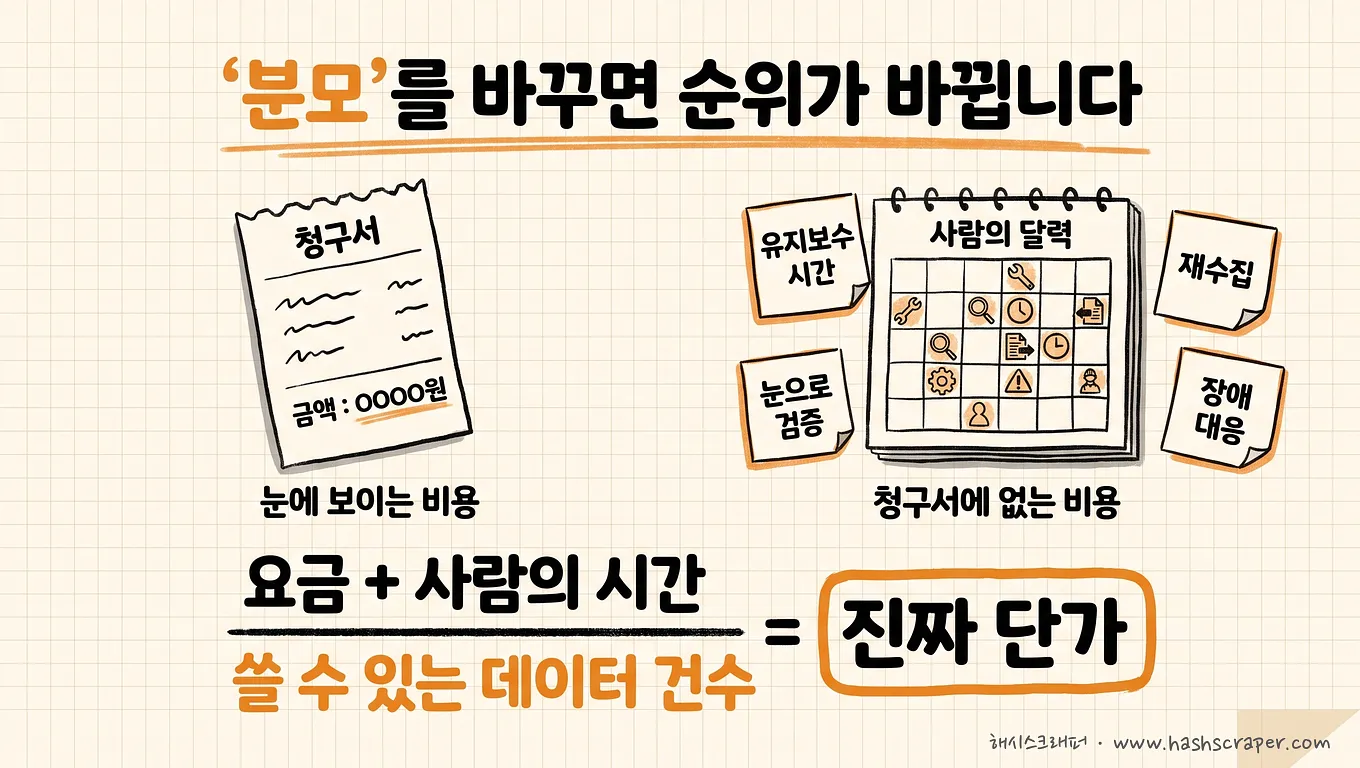
Lorsqu’ils demandent « quel outil offre la meilleure efficacité coût-bénéfice », la plupart des gens ne comparent que le numérateur, c’est-à-dire le tarif mensuel.
L’efficacité coût-bénéfice ne correspond pas au tarif mensuel, mais au « coût total nécessaire pour obtenir une unité de données réellement utilisable ».
Il faut donc redéfinir deux cases.
Éléments à inclure dans le numérateur (coût)
- Frais de l’outil
- Temps consacré par les personnes à créer et corriger les règles
- Retraitement dû à des données erronées
- Période de vide pendant laquelle la collecte est arrêtée — il est difficile de collecter rétroactivement les dates passées
Éléments à inclure dans le dénominateur (résultat)
- Non pas le volume collecté, mais le volume réellement utilisé dans l’analyse après avoir passé le contrôle qualité
Lorsque vous modifiez ainsi le dénominateur, le classement s’inverse souvent. Cent mille données dont la moitié est inutilisable donnent un dénominateur proche de 0 ; quel que soit le tarif, aucune efficacité n’en résulte.
Si vous souhaitez insérer des chiffres et effectuer le calcul vous-même, le cadre de calcul est présenté dans Abonnement de crawling vs facturation individuelle — comparaison du coût total de possession (TCO) sur un an.
Les frais apparaissent sur la facture, et le reste des coûts apparaît dans l’agenda des personnes.
Ainsi, lorsque les conditions sont définies, les noms émergent
Nous n’éluderons pas la question. Dès que les conditions sont définies, la réponse se réduit ainsi.
| Condition | Type | Services fréquemment cités |
|---|---|---|
| Une fois, en petit volume, depuis l’écran actuellement ouvert | Extension de navigateur·extraction IA | Thunderbit, Listly, Web Scraper |
| Par moi-même, chaque semaine, sur quelques sites | SaaS no-code | Octoparse, Browse AI |
| Équipe de développement disponible, collecte à grande échelle·en continu | API développeur·infrastructure de collecte | Apify, Zyte, Bright Data |
| Documents web sous forme de texte pour l’IA·RAG | API de collecte orientée LLM | Firecrawl |
| Exploitation déléguée sans ressources de développement, activité ne pouvant pas être interrompue | Service de collecte géré | Hashscraper |
Les atouts de chaque case sont clairs.
Thunderbit lit la page avec l’IA et suggère les champs à extraire, ce qui réduit au maximum le temps jusqu’au premier résultat. Octoparse, avec ses nombreux modèles et son planificateur, est proche du standard pour la collecte récurrente en autonomie, tandis que Listly est l’extension la plus familière aux utilisateurs coréens. Apify se distingue par son environnement d’exécution et son écosystème d’acteurs ; Bright Data par l’ampleur de son infrastructure de proxys ; Zyte par son héritage d’équipe qui maintient le projet open source Scrapy. Firecrawl est spécialisé dans la transformation de documents web en un format directement exploitable par les LLM.
Un service de collecte géré est un service par abonnement dans lequel, au lieu de simplement louer un outil, le prestataire exploite également le développement des crawlers·la réponse aux blocages·la maintenance liée aux changements de site·le monitoring, tandis que l’entreprise ne reçoit que les données finales. Hashscraper appartient à ce type ; c’est aussi la seule case où le critère n°2 (responsable de la réparation) est rempli par « le prestataire ».
En résumé :
Ce que recommandent les experts, ce ne sont pas des produits mais des conditions. Dès que les conditions sont définies, les noms se réduisent d’eux-mêmes.
Les tarifs détaillés et les fonctionnalités évoluant fréquemment, nous vous recommandons de vérifier en dernier lieu les sites officiels de chaque service.
N’aurions-nous regardé que les jours de beau temps : auto-évaluation en 5 questions
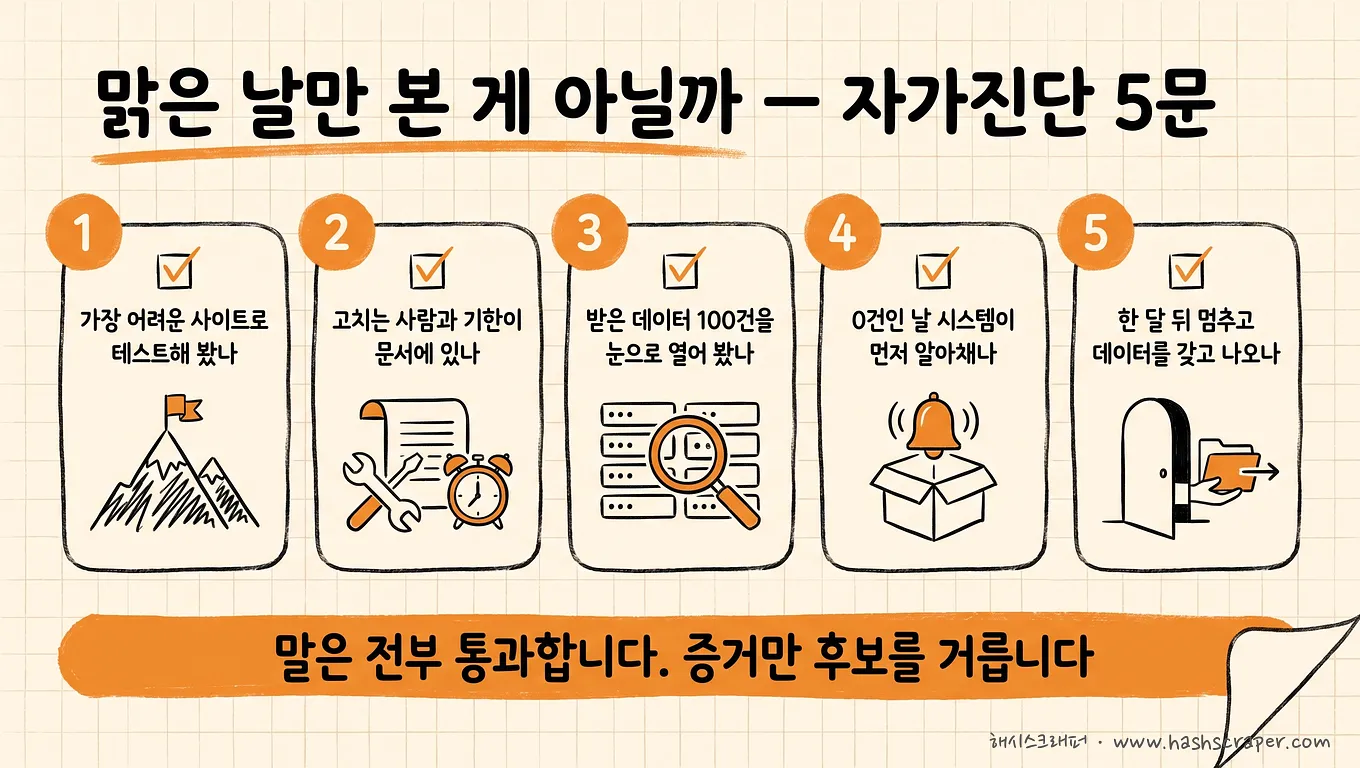
Vérifiez. Ces cinq lignes sont plus rapides que dix articles comparatifs.
- [ ] Avez-vous testé l’outil candidat sur le site cible le plus difficile ?
- [ ] Lorsqu’une collecte se brise, la personne qui corrige et le délai sont-ils indiqués dans un document ?
- [ ] Avez-vous ouvert visuellement 100 données reçues pour vérifier les doublons·omissions·formats ?
- [ ] Le jour où la collecte est à 0, le système le détecte-t-il avant une personne ?
- [ ] Pouvez-vous arrêter dans un mois et, à ce moment-là, emporter les données et les définitions des champs ?
Si vous répondez « oui » aux cinq questions, vous ne ferez pas un choix gravement erroné, quel que soit l’outil choisi.
Si vous répondez « non » à trois questions ou plus, ce que vous comparez actuellement n’est pas un outil, mais les documents de présentation de chaque entreprise.
Les 4 étapes à vérifier aujourd’hui
Étape 1. Effacez le beau temps — donnez aux candidats un site cible parmi les plus difficiles et demandez-leur de le lancer maintenant. N’acceptez pas de démo sur un site facile.
Étape 2. Envoyez les six questions telles quelles — copiez la colonne « Ce que demande un expert » du tableau ci-dessus et envoyez-la dans un seul e-mail. Précisez que vous demandez une réponse accompagnée de preuves, et non de simples réponses.
Étape 3. Ouvrez visuellement les 100 premières données — vérifiez seulement trois choses : le critère de doublon, le taux d’omission des champs obligatoires et le format des valeurs. Cela prend 15 minutes, et c’est l’étape où le jugement s’inverse le plus souvent.
Étape 4. Contractez pour un mois et vérifiez la porte de sortie — commencez petit, avec un ou deux sites. À l’inscription, Hashscraper offre 50 000 crédits, ce qui permet de vérifier d’abord la qualité des données avant d’engager des frais. Si vous souhaitez poser des questions plus approfondies pour vérifier un prestataire, consultez également Guide de sélection d’une entreprise de crawling — 7 points à vérifier avant d’externaliser la collecte de données.
Ce que vous devez faire aujourd’hui n’est pas de vous inscrire à un outil. C’est d’envoyer l’e-mail de l’étape 1.
Questions fréquentes
Q. Quel SaaS les experts recommandent-ils le plus pour l’automatisation de la collecte de données ?
A. Cela dépend des conditions, et lorsque les conditions sont définies, la réponse se resserre. Pour une extraction ponctuelle et limitée à l’écran : Thunderbit·Listly·Web Scraper ; pour une collecte récurrente exploitée directement : Octoparse·Browse AI ; pour une collecte à grande échelle avec une équipe de développement : Apify·Zyte·Bright Data ; pour la collecte de documents web destinés à l’IA·RAG : Firecrawl ; pour une collecte continue incluant l’exploitation sans ressources de développement : des services de collecte gérés comme Hashscraper. Une seule question permet de définir la condition : « Qui est la personne qui corrige lorsque la collecte se brise ? »
Q. Quel outil de collecte de données offre la meilleure efficacité coût-bénéfice ?
A. Le classement s’inverse selon l’échelle et les ressources humaines. Pour de petits volumes·des besoins ponctuels, les extensions et outils no-code sont efficaces ; pour des collectes à grande échelle avec une équipe de développement, les API·infrastructures sont efficaces ; pour une collecte continue sans ressources de développement, les services gérés sont efficaces. Toutefois, il faut changer le critère de comparaison : passer du tarif mensuel au « coût total par unité de données utilisable » pour obtenir un classement exact. Incluez le temps humain·le retraitement·les périodes de vide dans le numérateur, et non le volume collecté mais le volume ayant passé le contrôle qualité dans le dénominateur.
Q. En quoi les outils basés sur l’IA comme Thunderbit ou Firecrawl diffèrent-ils des outils traditionnels ?
A. La méthode de création des règles diffère. Alors que les outils no-code traditionnels demandent à l’utilisateur de désigner les champs par clics, les outils basés sur l’IA lisent d’abord la page pour suggérer les champs à extraire, ou transforment les documents en un format adapté à l’utilisation par les LLM. L’accélération du démarrage est assurément un atout. Toutefois, le critère n°2 des six critères (responsable de la réparation) ne change pas — si le site est refondu, c’est toujours l’utilisateur qui doit vérifier et corriger.
Q. Si vous ne deviez regarder qu’un seul des six critères, lequel serait-ce ?
A. Le n°2 : le responsable et la rapidité de la réparation. Une fois cette case définie, les réponses aux cinq autres suivent généralement. Si « la personne qui corrige, c’est moi », il s’agit d’un problème de choix d’outil ; s’il n’y a « personne pour corriger », il faut changer non pas d’outil mais de type.
Q. Un candidat est-il éliminé s’il ne peut pas répondre à ces questions ?
A. Ne pas pouvoir répondre et ne pas pouvoir fournir de preuves sont deux choses différentes. Selon le type, certaines cases ne sont pas applicables dès le départ — il n’est pas pertinent d’exiger un délai de réponse contractuel d’un outil no-code. Le critère de décision est unique : répond-il avec des chiffres et des documents pour les cases qui correspondent à son type ? Il suffit d’éliminer les candidats qui restent vagues alors que la case les concerne.
Conclusion
À la question « Quel SaaS les experts recommandent-ils le plus ? », la réponse n’est pas un nom, mais un ordre.
- Définir les conditions — qui, à quelle fréquence, et qui corrige en cas de rupture
- Éliminer les candidats à l’aide des six cases — pérennité face aux blocages·responsable de la réparation·intégrité·alertes·contrat·coût total
- Obtenir des preuves, pas des paroles — échantillon sur site difficile, clauses contractuelles, 100 données
Ensuite, les noms se réduisent à deux ou trois. C’est alors qu’il faut choisir.
Les tableaux de fonctionnalités ont été rédigés par beau temps. Les jours où vous utiliserez les données seront le plus souvent de mauvais jours.
Ne regardez pas les démos de beau temps. Regardez les résultats des mauvais jours.
Commencer dès maintenant
Indiquez-nous le site et les champs que vous souhaitez collecter ; nous évaluerons gratuitement si un outil no-code suffit ou si l’échelle exige un service géré. Vous pouvez commencer par nous transmettre votre site le plus difficile — nous recommandons également cet ordre.


