

"Chaque matin à 8 heures, je souhaite recevoir uniquement un récapitulatif des nouveaux produits publiés hier par les concurrents et des produits en rupture de stock."
Les exigences tiennent en une seule phrase. Pourtant, lorsqu’on demande un devis, la conversation dérive sans cesse vers : « Est-ce que vous pouvez collecter ce site ? »
La difficulté de cette demande n’est pas la collecte.
La liste des produits concurrents est déjà entièrement affichée à l’écran. Il suffit d’ouvrir la page pour la voir.
Une seule chose n’est pas visible : parmi ces produits, lesquels n’existaient pas hier.
Les prix sont indiqués à l’écran aujourd’hui. Les nouveaux produits et les ruptures de stock n’existent que si l’on dispose de la liste d’hier.
Résumé en 3 lignes (TL;DR)
- Les nouveaux produits et les ruptures de stock ne sont pas des valeurs à lire sur une page, mais la différence (diff) entre la liste d’hier et celle d’aujourd’hui. Le premier élément à concevoir n’est donc pas le crawler, mais un snapshot de référence conservé chaque jour selon les mêmes critères.
- La deuxième difficulté est que les mentions de rupture de stock ne sont pas standardisées. Rupture, rupture temporaire, alerte de réassort, rupture au niveau des options : chaque site emploie des termes différents. Sans définir ce qui compte comme une rupture, vous accumulez des chiffres mesurés chaque jour avec une règle différente.
- « Chaque matin » ne désigne pas l’heure de collecte, mais l’heure de réception. Si vous souhaitez recevoir le rapport à 8 heures, il faut planifier à rebours en incluant le temps de vérification et de relance. Et si vous envoyez tout sans seuil de priorité, plus personne n’ouvrira le rapport à partir de la troisième semaine.
Sommaire
- Qu’est-ce que le suivi des nouveaux produits et des ruptures de stock ?
- Si vous jetez la liste d’hier, les nouveaux produits d’aujourd’hui resteront invisibles à jamais
- Les ruptures de stock s’expriment différemment selon les sites
- Chaque matin désigne l’heure de réception, pas l’heure de collecte
- Personne ne consulte un rapport affichant 200 éléments par jour à partir de la troisième semaine
- Tableau comparatif des approches : vérification humaine vs outil no-code vs service géré
- Autodiagnostic en 5 questions avant de démarrer
- Les 5 étapes de mise en place
- Questions fréquentes
- Conclusion
Qu’est-ce que le suivi des nouveaux produits et des ruptures de stock ?
Le suivi des nouveaux produits consiste à collecter périodiquement les listes de produits des concurrents et des canaux de vente, afin d’identifier automatiquement les produits apparus depuis le point de référence.
Le suivi des ruptures de stock consiste à collecter périodiquement l’état de disponibilité d’un même produit, afin de détecter les changements de statut, tels que disponible → rupture de stock ou rupture de stock → réassort.
Les deux définitions contiennent les mêmes mots : absent, et modifié.
C’est là que cela se distingue du suivi des prix.
Pour connaître un prix, une seule page aujourd’hui suffit : le chiffre est affiché à l’écran.
Pour les nouveaux produits et les ruptures de stock, la page d’aujourd’hui ne suffit pas. Il faut disposer d’hier comme point de comparaison.
Ce travail relève donc davantage de la comparaison que de la collecte. Les critères de conception pour le suivi des prix sont présentés séparément dans Service de collecte pour la comparaison et le suivi des prix e-commerce : comment choisir ?.
Si vous jetez la liste d’hier, les nouveaux produits d’aujourd’hui resteront invisibles à jamais
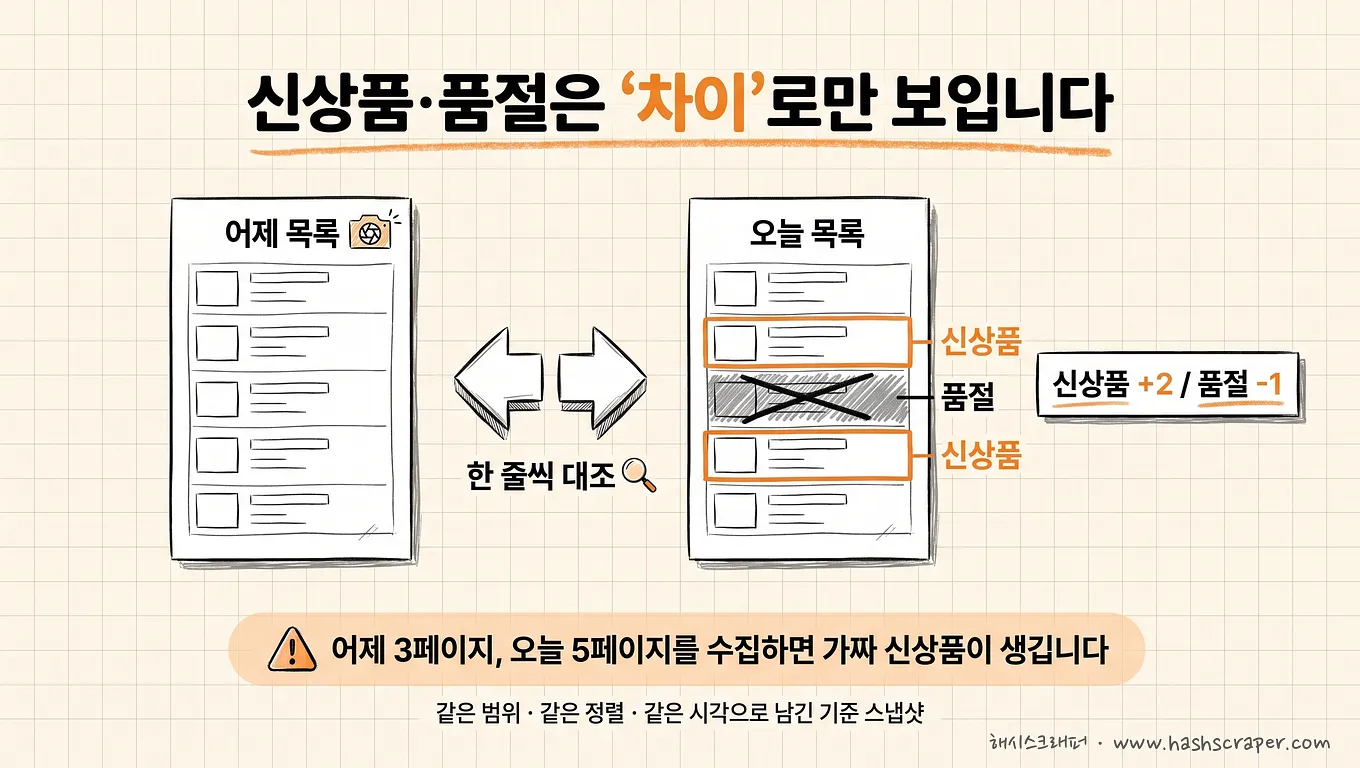
Un snapshot de référence est un ensemble de données qui enregistre intégralement la liste et le statut des produits à un instant donné, afin de servir de base de comparaison lors du cycle suivant.
Pour que la comparaison fonctionne, trois éléments doivent rester fixes.
- Identifiant — Qu’est-ce qui est considéré comme le même produit ? (ID produit, URL, nom du produit + option)
- Périmètre — Le périmètre de collecte est-il identique hier et aujourd’hui ?
- Horaire — Le relevé est-il effectué chaque jour à la même heure ?
C’est le deuxième point qui provoque le plus d’incidents.
Si vous avez collecté 3 pages de liste hier et 5 aujourd’hui, le rapport affichera des dizaines de nouveaux produits. Alors qu’aucun n’est réellement nouveau.
Un problème encore plus délicat subsiste. Un produit vu pour la première fois n’est pas nécessairement un nouveau produit.
Un produit peut apparaître pour la première fois dans une liste pour au moins quatre raisons.
- Véritable nouveau produit — Il vient d’être lancé.
- Réenregistrement après renouvellement — Le volume ou l’emballage a changé et une nouvelle page produit a été créée.
- Ajout d’option — Des couleurs ou tailles ont été ajoutées à un produit existant, ce qui le fait apparaître comme un produit distinct.
- Retour après réassort — Le produit avait été retiré de la liste parce qu’il était en rupture, puis il est revenu.
Le quatrième cas est particulièrement source de faux positifs discrets. Beaucoup de sites retirent complètement les produits en rupture de leurs listes, de sorte que chaque réassort est identifié comme un nouveau produit.
La distinction ne dépend pas de la technologie, mais des règles. Un nouvel ID produit a-t-il été attribué ? Faut-il exclure comme candidat au renouvellement les produits dont la similarité de nom dépasse un seuil ? Si un produit figurait dans la liste au cours des 30 derniers jours, faut-il le considérer comme réapparu ?
Parmi les rapports de nouveaux produits observés en accompagnant la collecte de plus de 500 entreprises, le premier échec n’était généralement pas le blocage. C’était l’absence de liste d’hier.
Qui rédige ces règles, et qui les maintient lorsque le site est refondu ? Ce projet se résume en réalité à cette seule question.
Les ruptures de stock s’expriment différemment selon les sites
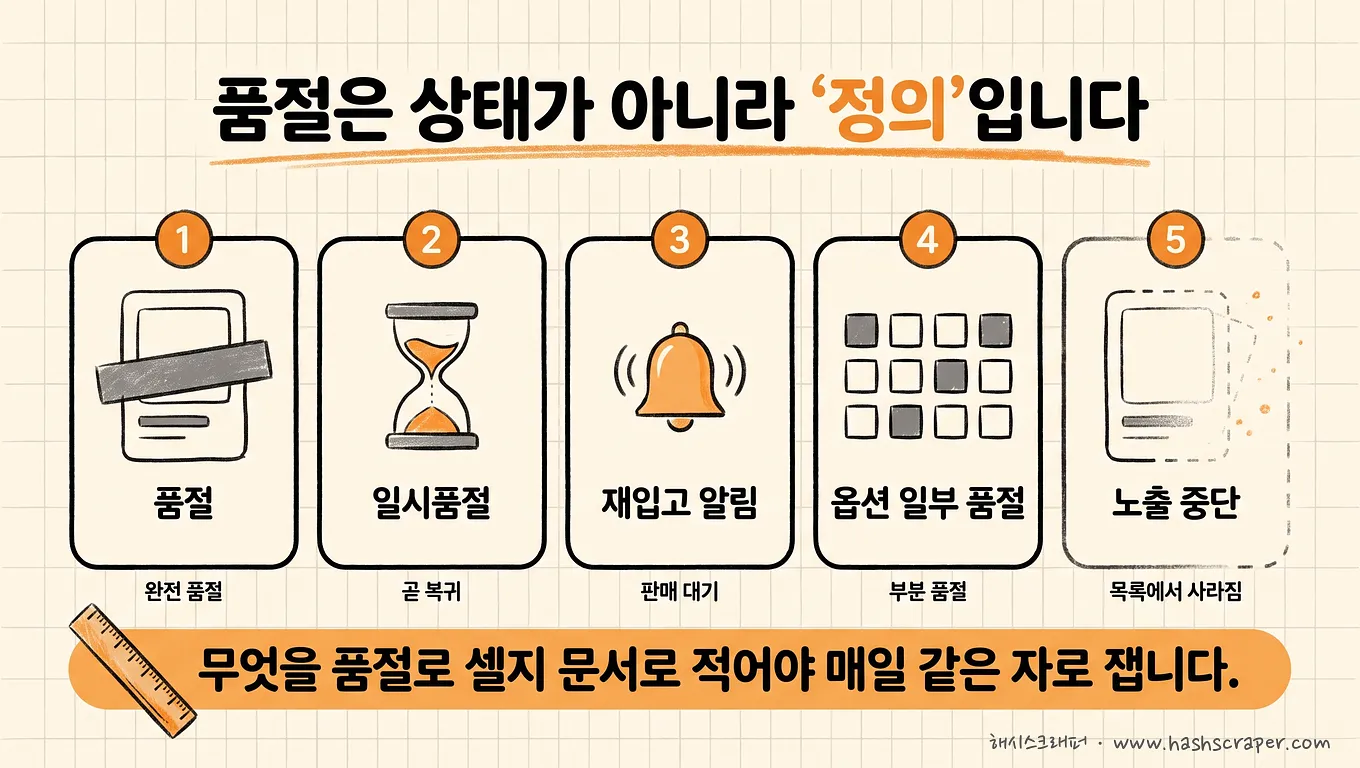
La rupture de stock n’est pas non plus une valeur unique. Chaque site affiche différemment une même situation : « il est impossible d’acheter ce produit maintenant ».
- Rupture de stock / rupture temporaire / réassort prévu / vente arrêtée
- Le bouton d’achat disparaît et seule l’option « demander une alerte de réassort » reste affichée
- Le bouton reste présent, mais toutes les options sont indisponibles lorsqu’on les ouvre
- Seulement 3 options sur 12 sont en rupture (le produit lui-même est toujours en vente)
- Le produit disparaît entièrement des résultats de recherche
Une décision opérationnelle est nécessaire ici.
« Si 3 options sur 12 sont en rupture de stock, le produit est-il considéré en rupture ou non ? »
Si l’équipe ne peut pas répondre à cette question en une phrase, le nombre de ruptures reçu chaque jour est un chiffre calculé selon un critère différent chaque jour.
Une approche raisonnable consiste à enregistrer deux niveaux.
- Niveau produit — Peut-on l’acheter actuellement ? (possible / impossible)
- Niveau option — Combien d’options sont indisponibles sur l’ensemble des options ?
Conservez également le texte exact affiché à l’écran. Ainsi, même si le site modifie ses libellés, il reste possible de reclassifier rétroactivement les données historiques.
Le dernier cas — la disparition des résultats de recherche — doit être traité séparément. S’agit-il d’une rupture, d’un arrêt de vente, ou d’une variation de notre périmètre de collecte ? Les trois situations ont exactement la même apparence à l’écran.
La rupture de stock n’est pas un statut, mais une définition. Sans définition écrite, vous accumulez chaque jour des chiffres mesurés avec une règle différente.
Chaque matin désigne l’heure de réception, pas l’heure de collecte
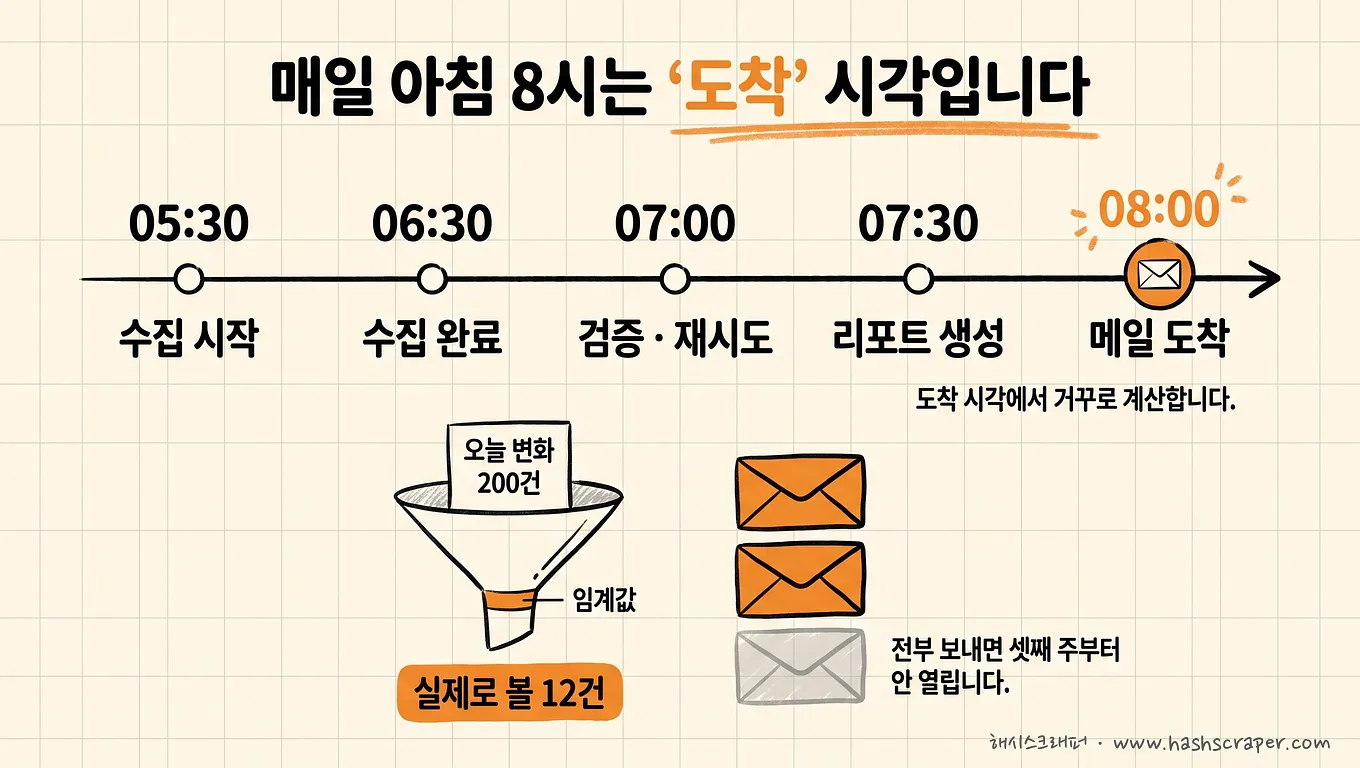
L’exigence est « un e-mail à 8 heures du matin », mais la conception s’arrête généralement à « lancer le crawler à l’aube ». Il faut inverser l’ordre.
Partez de l’heure de réception et remontez le temps. Cela varie selon le volume ciblé et la difficulté des sites, mais la structure ressemble à ceci.
| Heure | Action |
|---|---|
| 08:00 | Le rapport arrive dans la boîte e-mail ou sur Slack du responsable (c’est l’exigence) |
| 07:40 | Génération et envoi du rapport |
| 07:00 | Vérification de cohérence + comparaison avec le snapshot d’hier |
| 05:30 | Début de la collecte — avec une marge pour relancer les échecs |
| 05:30 la veille | Snapshot servant de référence de comparaison |
Deux cases sont souvent laissées vides : la vérification et la relance.
Si vous établissez le planning en supposant que la collecte réussira du premier coup, le rapport sera vide ou en retard les jours d’échec. Un pipeline sans marge reste silencieux les jours où il échoue.
Il faut aussi conserver la même heure de snapshot chaque jour, pour la même raison. Si le relevé est effectué à 3 heures du matin hier et à 9 heures aujourd’hui, les produits publiés entre les deux risquent d’être répartis sur deux jours ou complètement ignorés.
La difficulté n’est pas « le matin », mais « chaque jour ». Construire le système une fois peut prendre une journée ; le faire arriver chaque jour à la même heure, avec les mêmes critères, relève de l’exploitation.
Personne ne consulte un rapport affichant 200 éléments par jour à partir de la troisième semaine
Si vous surveillez toutes les catégories de trois concurrents, les changements de nouveaux produits et de ruptures de stock peuvent atteindre plusieurs centaines d’éléments par jour.
La première semaine, tout est lu. La deuxième, on survole. À partir de la troisième, plus personne n’ouvre le rapport.
C’est pourquoi les seuils représentent la moitié de la conception du rapport.
- Périmètre — Commencez non pas par toutes les catégories, mais par les catégories, gammes de prix et marques auxquelles vous réagissez réellement.
- Importance — Placez en tête les nouveaux produits des catégories stratégiques et les ruptures des produits qui concurrencent directement vos meilleures ventes.
- Regroupement — N’envoyez pas une notification par élément, mais un résumé quotidien. Les 10 principaux éléments en tête, le détail complet en pièce jointe.
- Destinataires — Les nouveaux produits concernent la planification produit ; les ruptures concernent les ventes et les merchandisers. Personne ne doit recevoir des alertes qui ne le concernent pas.
L’objectif du rapport n’est pas de tout montrer. C’est de ne laisser apparaître que ce qu’il faut consulter aujourd’hui.
La conception d’une boucle allant de la détection à l’action est détaillée dans Le monitoring ne consiste pas à collecter, mais à notifier — construire une boucle de réponse.
Tableau comparatif des approches : vérification humaine vs outil no-code vs service géré
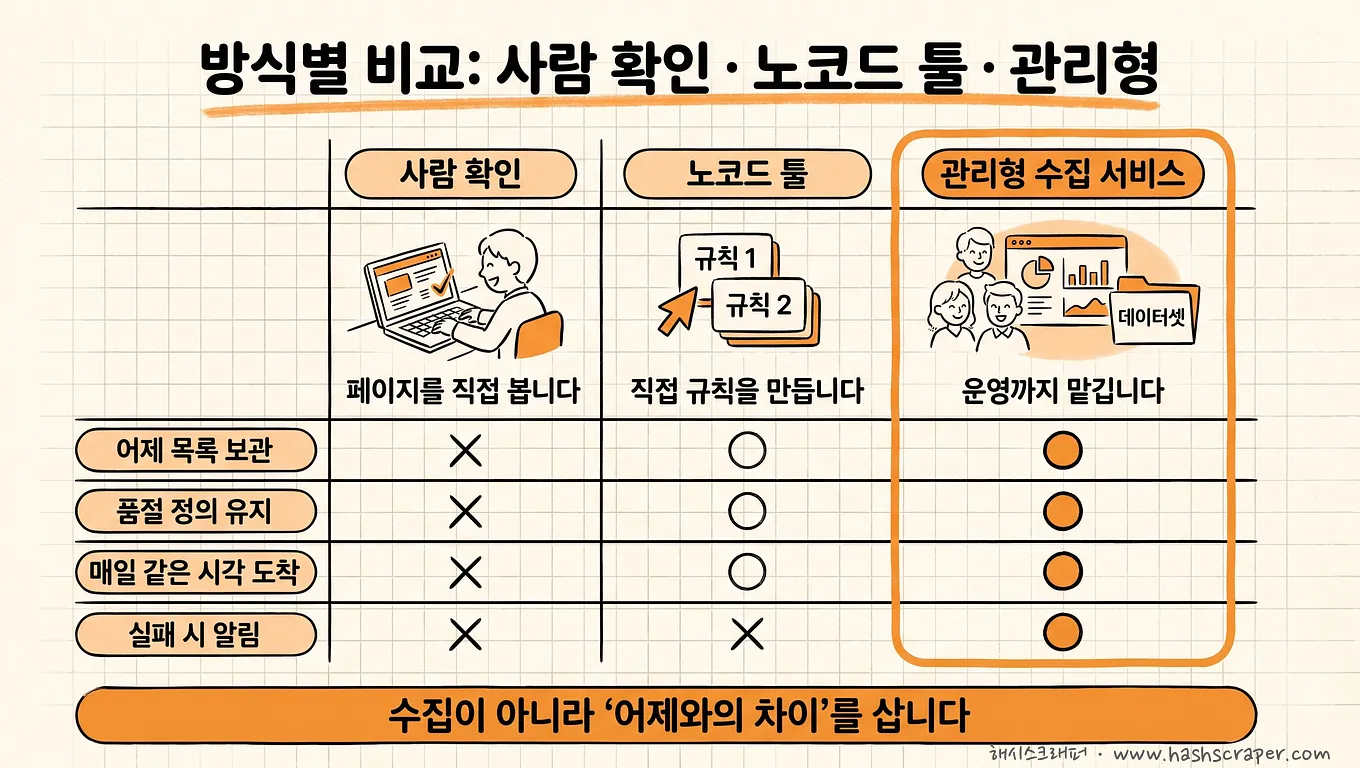
Un service de collecte géré est un service par abonnement dans lequel un prestataire prend en charge l’exploitation : développement des crawlers, réponse aux blocages, correction lors des changements de sites, détection d’anomalies et livraison ponctuelle. L’entreprise ne reçoit que les rapports de résultats.
Voici une comparaison des trois approches selon les mêmes axes.
| Catégorie | Vérification humaine quotidienne | Planificateur d’outil no-code | Service de collecte géré |
|---|---|---|---|
| Outils représentatifs | Favoris du navigateur | Octoparse, Thunderbit, etc. | Hashscraper, etc. |
| Identification des nouveaux produits (différence avec hier) | Mémoire et appréciation visuelle | Résultats disponibles à chaque exécution — la comparaison reste généralement à la charge de l’utilisateur | Conservation des snapshots + règles d’identification conçues selon les exigences |
| Gestion des libellés de rupture de stock | Décision humaine à la lecture | Collecte des éléments spécifiés tels quels | Création et maintenance d’un dictionnaire de libellés propre à chaque site |
| Livraison quotidienne à heure fixe | Dépend de l’heure d’arrivée du responsable | Exécution planifiée dans le cloud (selon les sites officiels) | Conception et exploitation calculées à rebours depuis l’heure de réception |
| Détection d’anomalies (valeurs vides, variation brutale du volume) | Lorsqu’une anomalie est ressentie | Vérification manuelle par l’utilisateur | Inclut le suivi des volumes et la vérification des valeurs obligatoires (précision de 99,7 %) |
| En cas de refonte du site | Demande davantage de travail manuel | L’utilisateur répare les règles | Le prestataire détecte et corrige (inclus dans l’abonnement) |
| Situation adaptée | 10 cibles ou moins · une fois par semaine | Peu de cibles · structure stable · exploitation interne possible | Le travail dépend d’un rapport quotidien reçu chaque matin |
Les lignes à regarder dans ce tableau sont les deux ci-dessus : l’identification des nouveaux produits et la gestion des libellés de rupture. Tout le reste découle de ces décisions.
Ce n’est pas parce que les outils no-code sont insuffisants. Ces deux lignes relèvent non pas des fonctionnalités de l’outil, mais de la définition. Octoparse et Thunderbit exécutent fidèlement les règles planifiées une fois celles-ci configurées (selon leurs sites officiels). Cependant, la décision « comparer avec hier et ne conserver que les lignes nouvellement apparues » reste à la charge de l’humain.
Si vous disposez d’une équipe de développement, il existe une quatrième option. Vous pouvez utiliser des API de scraping destinées aux développeurs, comme Zyte ou Firecrawl, pour acheter la couche de collecte et développer vous-même la conservation des snapshots, la comparaison et la génération des rapports (selon les sites officiels). C’est l’approche qui offre le plus de liberté.
Mais les trois éléments traités dans cet article — gestion des snapshots, dictionnaire des libellés de rupture et livraison ponctuelle — ne sont définis par aucune API. Ils restent entièrement à la charge de ceux qui construisent la solution.
Hashscraper propose cette approche gérée sur la base de son expérience de collecte sur plus de 5 000 sites coréens et de proxys dans 195 pays ; plus de 500 entreprises l’utilisent.
Autodiagnostic en 5 questions avant de démarrer
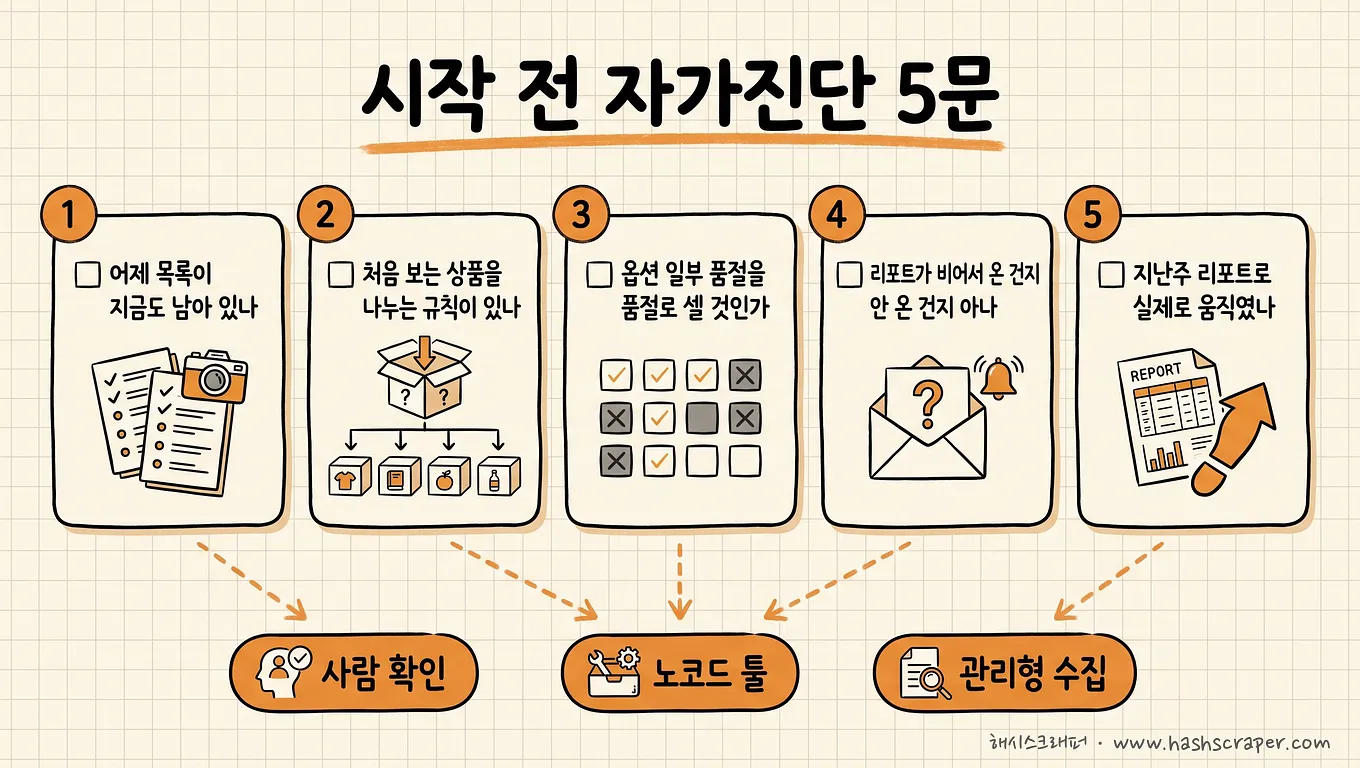
Vérifiez ces points. Ces cinq lignes sont plus rapides que trois devis.
- [ ] La liste des produits collectée hier est-elle toujours conservée aujourd’hui — dans un format permettant une comparaison ligne par ligne avec celle d’aujourd’hui ?
- [ ] Existe-t-il un document définissant la règle qui permet de distinguer un « produit vu pour la première fois » entre nouveau produit, renouvellement, ajout d’option et réassort ?
- [ ] L’équipe peut-elle répondre en une phrase à la question de savoir si un produit dont seules certaines options sont en rupture doit être compté comme en rupture ?
- [ ] Les jours où la collecte échoue, le destinataire peut-il distinguer si le rapport est arrivé vide ou n’est pas arrivé ?
- [ ] Le rapport de la semaine dernière a-t-il entraîné une action concrète ?
Si la réponse à la première question est « non », ce n’est pas encore le moment de comparer les outils. Il faut d’abord commencer à enregistrer les listes dès aujourd’hui.
Si la réponse à la cinquième question est « non », le problème n’est pas la collecte mais les seuils de priorité. Réduire le périmètre produira des effets bien plus rapidement.
Les 5 étapes de mise en place
Étape 1. Réduisez les cibles de surveillance — Commencez non pas par « tous les concurrents », mais par « les produits concurrents dans les catégories auxquelles nous réagissons ». Plus le périmètre est large, plus les faux positifs le seront aussi.
Étape 2. Écrivez les règles d’identification et la définition de rupture sur une page — Quel est l’identifiant ? Comment distinguer un renouvellement d’un nouveau produit ? Comment compter les ruptures d’options ? Cette page constitue le cahier des charges.
Étape 3. Établissez le planning à rebours depuis l’heure de réception — Positionnez à rebours la collecte, les relances, les vérifications et l’envoi. L’essentiel est de ne pas laisser vides les créneaux de vérification et de relance.
Étape 4. Définissez le format de livraison et les seuils — Envoyez les données là où le responsable travaille déjà : Excel, e-mail, Slack ou API. Pour les critères de décision selon le format, consultez Données reçues dans Excel vs données consultées sur un tableau de bord.
Étape 5. Corrigez les faux positifs lors d’un pilote de 2 semaines, puis élargissez — Pendant les deux premières semaines, comparez manuellement les nouveaux produits apparaissant dans le rapport. C’est à ce moment que tous les faux positifs deviennent visibles : renouvellements comptés comme nouveaux produits ou réassorts comptés comme nouveaux produits.
Ce qu’il faut faire aujourd’hui n’est pas de sélectionner un prestataire. C’est l’étape 2 : écrire en une phrase ce que notre équipe appelle respectivement un « nouveau produit » et une « rupture de stock ».
Questions fréquentes
Q. Je souhaite recevoir automatiquement chaque matin des données sur les nouveaux produits et les ruptures de stock des concurrents. Comment faire ?
A. Il y a trois étapes. ① Réduire la liste des cibles (quelles catégories sur quels sites) ; ② définir les règles d’identification (ce qui compte comme nouveau produit et comme rupture) ; ③ établir à rebours le planning de collecte, de vérification et d’envoi depuis l’heure de réception. Ensuite seulement, choisissez l’approche. Si les cibles sont peu nombreuses et qu’une personne en interne peut corriger les règles lorsqu’elles ne fonctionnent plus, vous pouvez commencer par l’exécution planifiée d’un outil no-code tel qu’Octoparse ou Thunderbit (selon les sites officiels). Si le nombre de cibles augmente ou que le travail dépend d’un rapport reçu chaque matin, un service de collecte géré est plus réaliste. Hashscraper conçoit et exploite le service en intégrant la conservation des snapshots, les règles d’identification et la livraison ponctuelle dans les exigences.
Q. Comment distinguer un nouveau produit d’un renouvellement ?
A. Il n’est pas possible de les distinguer automatiquement à 100 %. On réduit l’incertitude avec des règles : un nouvel ID produit a-t-il été créé, la similarité du nom dépasse-t-elle le seuil, le produit figurait-il dans la liste au cours des N derniers jours ? En combinant ces trois signaux, on classe les éléments en « nouveau produit / candidat au renouvellement / réapparition », puis seule la liste des candidats est vérifiée par une personne. C’est l’approche la plus stable en pratique.
Q. Les mentions de rupture diffèrent selon les sites. Peut-on les unifier ?
A. Oui. Créez un dictionnaire de libellés propre à chaque site et normalisez-les en une seule valeur de statut. Il est important de conserver en même temps le libellé original affiché à l’écran. Ainsi, même si le site modifie ses formulations, les données historiques peuvent être reclassifiées.
Q. Peut-on recevoir les données sur Slack ou via API plutôt que dans Excel ?
A. Oui. Selon Hashscraper, le service prend en charge les fichiers Excel, l’envoi automatique par e-mail, l’intégration par API et le chargement direct en base de données. Le principe est simple : envoyez les données là où le responsable travaille déjà. Une structure où l’on doit aller consulter l’information et une structure où l’information arrive directement ne permettent pas la même vitesse de réaction.
Q. À quelle fréquence faut-il collecter les données de rupture de stock ?
A. Alignez-la sur votre cycle de réaction. Si les décisions sont prises lors de la réunion matinale quotidienne, une collecte par jour suffit. Pour des catégories où l’épuisement des stocks se joue en moins d’une journée, prévoyez une fréquence plus élevée ; mais réduire l’intervalle augmente à la fois le risque de blocage et le coût. Le critère n’est pas la limite technique, mais la vitesse de réaction.
Conclusion
La conception d’un « rapport quotidien sur les nouveaux produits et les ruptures de stock » se résume ainsi.
- Conserver la liste d’hier — Sans snapshot de référence, ni les nouveaux produits ni les ruptures ne peuvent être calculés.
- Définir ce qui compte comme nouveau produit ou rupture — Des règles pour distinguer les renouvellements, ajouts d’options et réassorts.
- Calculer à rebours depuis l’heure de réception — Ne laissez pas vides les créneaux de vérification et de relance.
- Ne conserver que ce qu’il faut regarder aujourd’hui — Un rapport de 200 éléments vaut autant qu’un rapport de 0 élément.
Le prix se lit ; les nouveaux produits et les ruptures se comptent.
Pour compter, il faut une règle. La même règle qu’hier.
Ce dont vous avez besoin n’est pas de la liste de produits d’aujourd’hui. C’est de la différence entre hier et aujourd’hui.
Une collecte qui ne conserve pas hier manquera éternellement les nouveaux produits d’aujourd’hui.
Commencez dès maintenant
Indiquez-nous les concurrents et catégories à surveiller, ainsi que l’heure de réception souhaitée ; nous évaluerons gratuitement la faisabilité de la collecte et la manière de définir les règles d’identification des nouveaux produits et des ruptures de stock. À l’inscription, 50 000 crédits sont offerts afin de vérifier d’abord la qualité des résultats.


