

"Nous avons collecté 30 000 avis."
À partir du moment où cette phrase figure dans un rapport, personne ne pose la question suivante.
30 000 avis sur combien au total ?
S'il y en a 40 000 au total, ce sont d'excellentes données. S'il y en a 400 000 et que seuls les 30 000 plus récents ont été récupérés, ce n'est pas de la VOC, mais un rassemblement de personnes récemment mécontentes.
Les mêmes 30 000 avis. Des conclusions diamétralement opposées.
Le point où l'analyse des avis se trompe n'est généralement pas l'analyse. C'est l'échantillon.
Résumé en 3 lignes (TL;DR)
- Le critère de choix d'un service de collecte d'avis et de VOC n'est pas « combien peut-il récupérer ? », mais « quelle partie de la population a-t-il prélevée, et comment ? ». Un prix erroné finit un jour par se remarquer, mais un avis manquant n'apparaît pas à l'écran et reste donc invisible jusqu'au bout.
- Les avis ont une nature différente des prix et des stocks. Leur date de rédaction est répartie sur tout le passé, la pagination et le tri évoluent pendant la collecte, et les doublons comme les omissions surviennent simultanément. Il ne s'agit pas de « trouver la bonne valeur actuelle », mais de « récupérer sans omission l'intégralité de l'historique ».
- Il existe trois approches. Pour une vérification ponctuelle à petit volume, utilisez des outils no-code (Thunderbit, Octoparse, etc.) ; si vous avez une équipe de développement, optez pour le développement interne (Scrapy, Zyte, Firecrawl, etc.) ; si vous devez recevoir chaque jour la VOC de l'ensemble des canaux sans équipe de développement, choisissez un service de collecte managé (Hashscraper propose cette approche avec une expérience de collecte sur plus de 5 000 sites coréens, des proxys dans 195 pays et une précision des données de 99,7 %).
Table des matières
- Qu'est-ce que la collecte d'avis et les données VOC ?
- Les avis sont différents des prix : les données manquantes ne sont pas visibles à l'écran
- Les 5 voies par lesquelles un échantillon se biaise
- Définissez d'abord ce que vous allez contenir : conception des champs de collecte d'avis
- Pourquoi les avis de boutiques en ligne sont particulièrement complexes : blocages, connexion et données personnelles
- Tableau comparatif des approches : outils no-code vs développement interne vs service managé
- Les 5 questions d'auto-diagnostic avant contrat
- Les 5 étapes de mise en place
- Après la collecte vient l'analyse
- Questions fréquentes
- Conclusion
Qu'est-ce que la collecte d'avis et les données VOC ?
Les données VOC clients désignent l'ensemble des traces textuelles des réactions des clients à un produit ou un service, telles que les avis, notes, demandes de renseignements et mentions sur les réseaux sociaux.
Elles diffèrent des sondages sur un point : le client les a laissées de son propre chef, sans que nous les lui demandions. Elles sont donc nombreuses, de formats variés et dispersées sur de multiples canaux.
La collecte d'avis consiste à récupérer automatiquement, à intervalles définis, ces textes dispersés sur les sites e-commerce, les boutiques d'applications, les cartes et les communautés, afin de les réunir dans un tableau unique.
Deux décisions sont déjà nécessaires à ce stade. Jusqu'où collecter, et quelles informations mettre sur chaque ligne. Le véritable critère de choix d'un service est de savoir qui prend la responsabilité de ces deux décisions.
Les avis sont différents des prix : les données manquantes ne sont pas visibles à l'écran
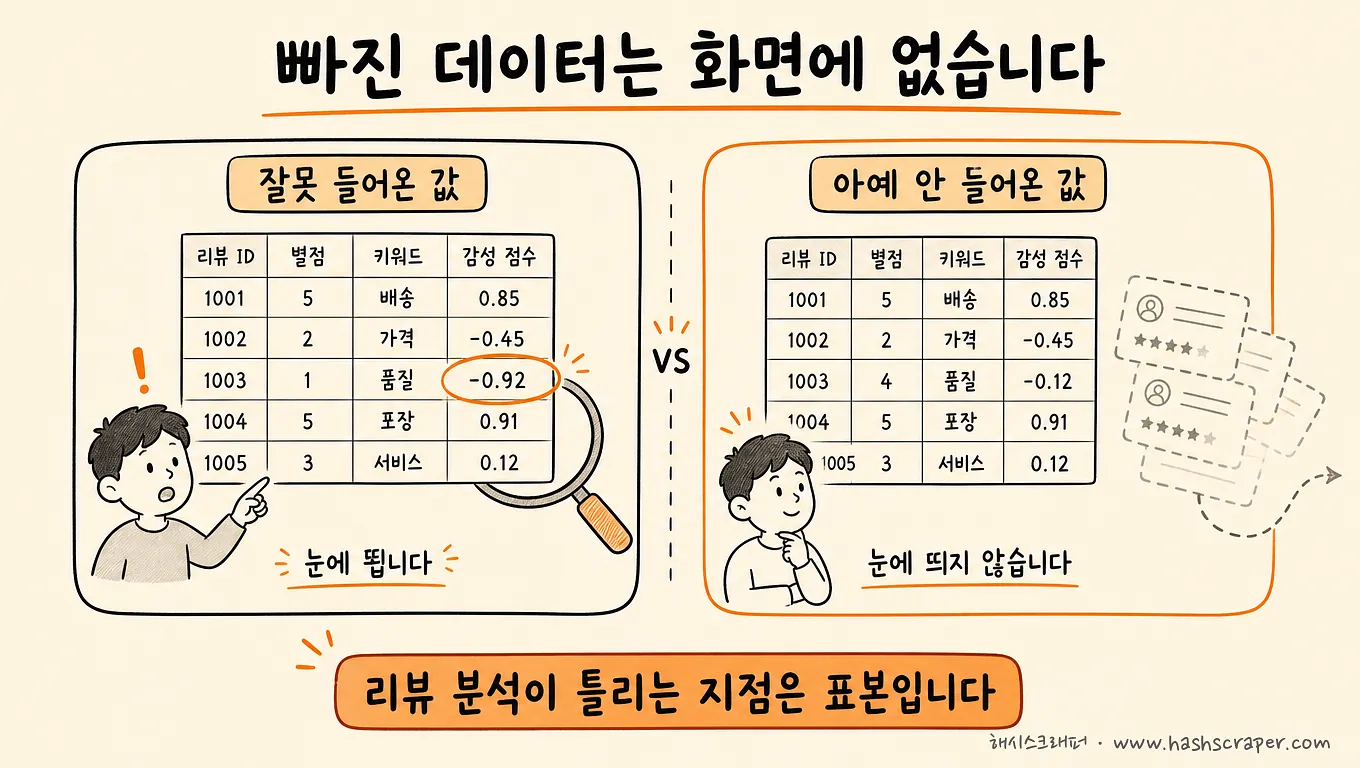
Un prix est une valeur unique à cet instant précis. Même s'il est erroné aujourd'hui, il sera mesuré à nouveau demain.
Les avis sont un ensemble couvrant tout le passé. Trois années d'avis peuvent s'être accumulées, et ceux d'hier comme ceux d'il y a trois ans sont tout aussi valides.
Cette différence engendre cinq difficultés opérationnelles.
- Les dates de rédaction sont dispersées — elles ne se trouvent pas sur un seul écran. Il faut parcourir toutes les pages pour constituer l'échantillon.
- La pagination est profonde — un seul produit peut compter des dizaines, voire des centaines de pages d'avis.
- Le tri évolue pendant la collecte — si un nouvel avis est publié pendant la lecture de la troisième page, les pages suivantes sont entièrement décalées.
- Les doublons et les omissions apparaissent simultanément — les avis décalés sont collectés une seconde fois, tandis que d'autres sont manqués dans la même proportion.
- Les réponses se trouvent au-delà de la note — une moyenne de 4,3 étoiles n'explique rien. Les raisons sont dans le texte, les options et les images.
La différence décisive apparaît à la fin. Lorsqu'un prix est erroné, quelqu'un finira par dire : « Ce chiffre est étrange, non ? » Parce qu'il peut être comparé à l'écran.
Personne ne signale un avis manquant. Ce qui est absent n'apparaît pas dans le tableau.
Les données incorrectes sont visibles. Les données qui ne sont jamais arrivées ne le sont pas.
Les 5 voies par lesquelles un échantillon se biaise
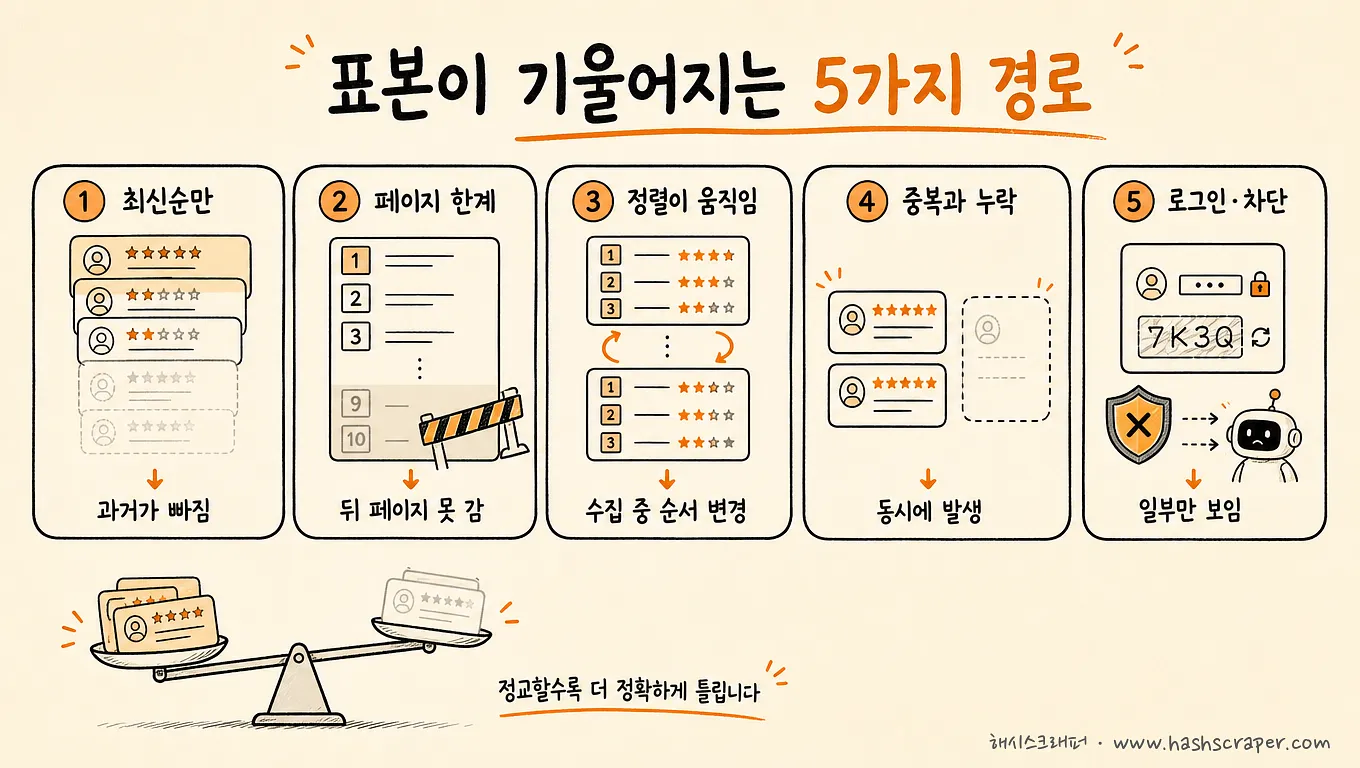
En accompagnant la collecte de plus de 500 entreprises, nous avons constaté que presque tous les échecs concernant les données d'avis relevaient de l'une de ces cinq catégories.
1. Le biais du tri par ordre récent. Si le tri par défaut reste celui des plus récents et que seules les premières pages sont récupérées, l'échantillon se concentre sur le « récent ». Les avis présentent des caractéristiques totalement différentes selon les périodes, les saisons, les promotions et les problèmes de qualité.
2. La coupure de profondeur de pages. Si l'on fixe une limite à « jusqu'à la page 20 », tout ce qui suit devient inexistant dans les données. Le problème est que les produits populaires sont les plus amputés. Les produits les plus importants sont les plus gravement dégradés.
3. Les doublons et omissions dus aux variations de tri. Si de nouveaux avis sont publiés pendant la collecte, l'ordre se décale. Sans se baser sur un identifiant unique d'avis, le même avis est récupéré deux fois, tandis que d'autres ne sont jamais récupérés.
4. Le piège des meilleurs avis et des avis les plus utiles. Si l'on ne collecte que l'onglet « meilleurs avis », l'échantillon penche vers le positif. Ce sont les avis que la plateforme a choisi de mettre en avant.
5. L'omission de canaux. Si un canal est exclu à cause d'un blocage ou d'une connexion requise, toute la clientèle utilisant ce canal disparaît. Une VOC sans avis d'application est une VOC sans la voix des utilisateurs de l'application.
Ces cinq voies ont un point commun : le rapport a toujours l'air parfaitement normal. Les graphiques sont générés, le taux de commentaires négatifs est calculé, et le nuage de mots est joli.
Quand l'échantillon est biaisé, plus l'analyse est sophistiquée, plus elle se trompe avec précision.
Définissez d'abord ce que vous allez contenir : conception des champs de collecte d'avis
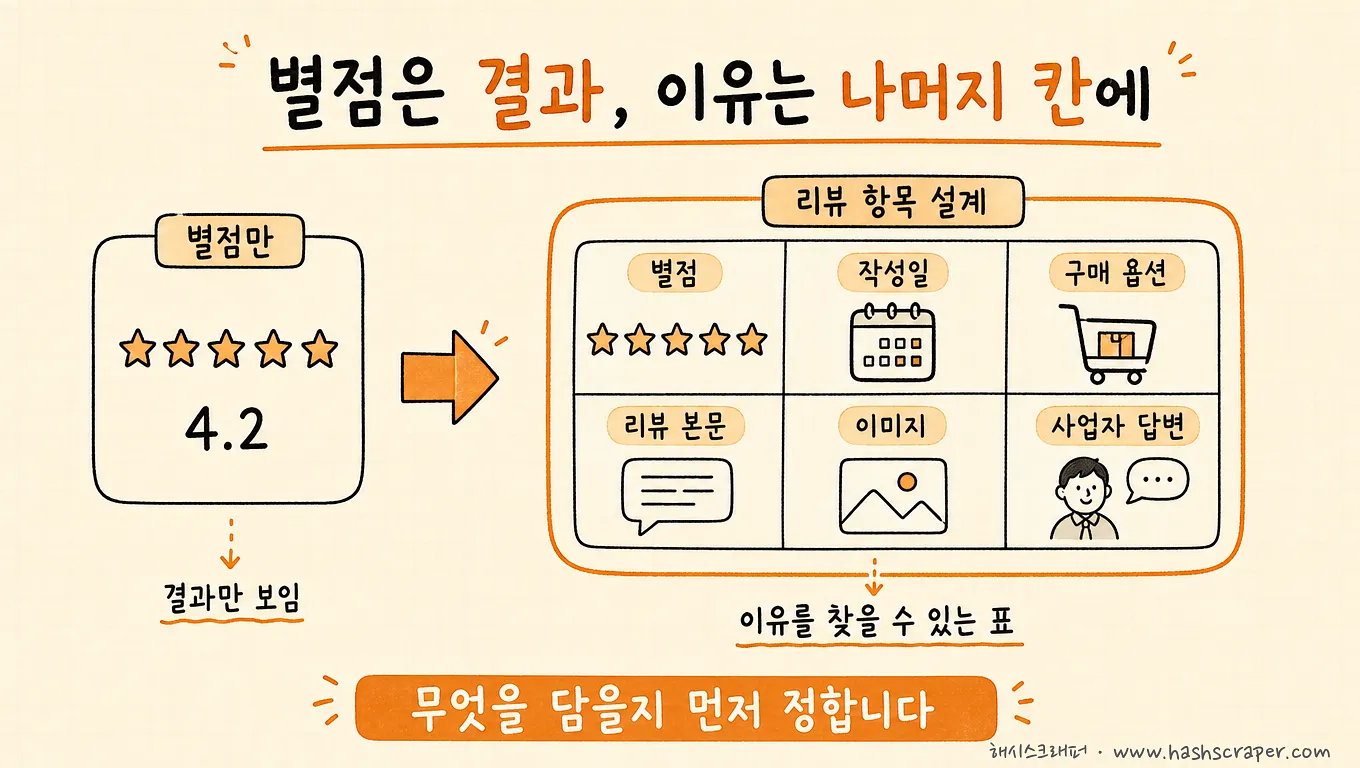
Après l'échantillon viennent les champs. Lorsqu'un avis devient une ligne dans un tableau, que doit contenir cette ligne ?
| Champ collecté | Pourquoi est-il nécessaire ? |
|---|---|
| Note | L'ossature des tendances. Elle ne permet toutefois pas à elle seule de connaître les raisons |
| Texte de l'avis | La substance de la VOC. L'objet de l'analyse |
| Date de rédaction | La référence pour les comparaisons chronologiques et la vérification des biais d'échantillonnage |
| Option d'achat·SKU | « Quelle couleur ou quelle capacité génère de l'insatisfaction ? » |
| Image de l'avis | Les réclamations non formulées par écrit, telles que les dommages ou les différences de couleur |
| Réponse du commerçant | Le suivi de la prise en charge et des réactions après réponse |
| Canal·pays | La comparaison par canal et l'intégration de VOC multilingues |
| Identifiant unique de l'avis | La clé de la déduplication et de la collecte incrémentale |
La dernière ligne est le champ le plus souvent oublié en pratique, et celui que l'on regrette le plus.
Sans identifiant unique, il est impossible de savoir si l'avis reçu hier est le même que celui reçu aujourd'hui. La déduplication se réduit alors à comparer les chaînes de texte, et les avis courts (« J'aime ») sont tous fusionnés en un seul.
La note est le résultat. Les raisons se trouvent toujours dans les autres colonnes.
Pourquoi les avis de boutiques en ligne sont particulièrement complexes : blocages, connexion et données personnelles
Blocages. Les avis se trouvent une couche plus profondément que les pages produit, et chaque produit génère des dizaines à des centaines de requêtes.
Pour 1 000 produits, il ne s'agit pas de 1 000 requêtes, mais de dizaines de milliers. Le volume de requêtes augmente non pas par addition, mais par multiplication. Dans un environnement où les grands sites e-commerce détectent les accès automatisés, des proxys et une conception des requêtes adaptée sont indispensables.
Connexion et avis réservés aux acheteurs. Certains canaux n'affichent tous les avis qu'en état connecté. Forcer les choses à ce stade ne relève plus d'un problème technique, mais d'un problème de conditions d'utilisation. Le principe est simple : collecter dans le périmètre public et dire clairement qu'un canal inaccessible ne l'est pas.
Données personnelles. Les avis peuvent contenir un pseudonyme, une partie d'identifiant ou une option d'achat. Il est plus sûr d'exclure dès la phase de conception des champs les informations d'identification qui ne seront pas utilisées pour l'analyse. Hashscraper collecte dans les limites des données publiques et maintient un bilan de zéro problème juridique lié à la collecte.
Une question plus importante que « Est-ce possible ? » est : « Qu'est-ce qui ne l'est pas ? »
Tableau comparatif des approches : outils no-code vs développement interne vs service managé
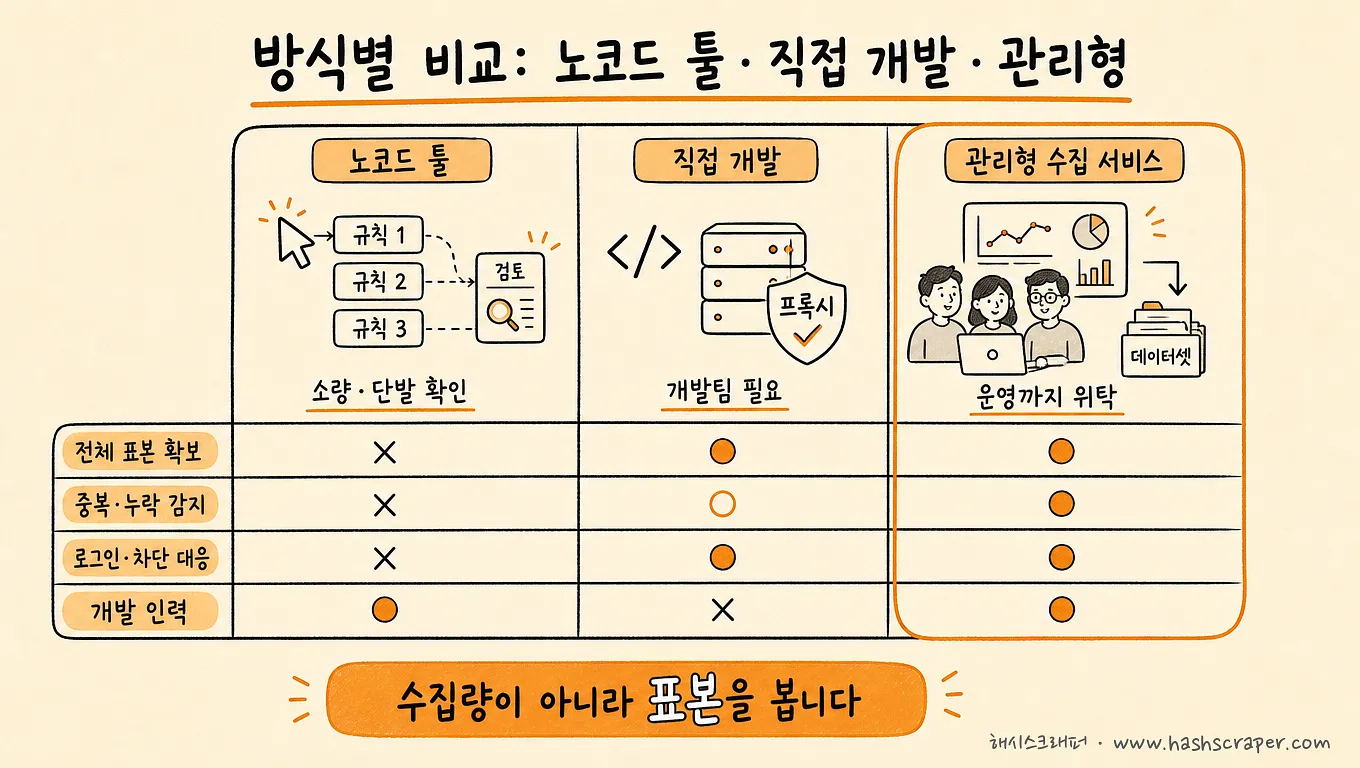
Un service de collecte managé est un service par abonnement dans lequel le prestataire exploite à votre place l'ensemble du processus, du développement des crawlers à la gestion des blocages, aux réparations lors des changements de sites et au suivi de la collecte, tandis que l'entreprise ne reçoit que des données de résultat vérifiées.
Si l'on compare les trois approches de collecte d'avis et de VOC selon les mêmes critères, voici les différences.
| Catégorie | Outils no-code (Thunderbit, Octoparse, etc.) | Développement interne (Scrapy·Zyte·Firecrawl, etc.) | Service de collecte managé (Hashscraper, etc.) |
|---|---|---|---|
| Collecte massive et exhaustive | Petit à moyen volume. Contraintes de profondeur de pages et de durée d'exécution | Dépend de la conception, avec pratiquement aucun plafond | Exigences conçues sur la base de l'exhaustivité (expérience sur plus de 5 000 sites coréens) |
| Gestion des blocages et de la connexion | Niveau de base, limité face aux blocages forts | Construction directe des proxys et sessions | Prise en charge par le prestataire (proxys dans 195 pays) |
| Cohérence de l'échantillon (doublons·omissions) | Vérification visuelle par l'utilisateur | Développement direct de la logique de vérification | Vérification incluse (précision de 99,7 %) |
| Responsable de la maintenance | Utilisateur | Équipe de développement en continu | Prestataire (inclus dans l'abonnement) |
| Intégration à l'analyse | Téléchargement d'un fichier et traitement séparé | Construction directe du pipeline | Collecte et analyse par IA dans un même pipeline |
| Situation adaptée | Vérifier une fois quelques produits | La collecte est une compétence clé + équipe de développement disponible | Recevoir quotidiennement tous les canaux sans équipe de développement |
Thunderbit est un outil sous forme d'extension de navigateur où l'IA propose les champs de collecte, ce qui en fait la solution la plus rapide à prendre en main ; Octoparse est un SaaS no-code représentatif qui permet de créer des règles par clics et de les exécuter dans le cloud. Zyte est une infrastructure de collecte destinée aux développeurs, proposée par l'entreprise qui a créé Scrapy, tandis que Firecrawl est une API pour développeurs qui transforme les pages web dans un format facile à lire pour les LLM.
Ces quatre outils sont tous de bons outils (les tarifs et fonctionnalités détaillés évoluant fréquemment, nous recommandons de les vérifier sur leurs sites officiels). Ils ont toutefois un prérequis commun : notre équipe doit disposer de quelqu'un capable de définir les critères de l'échantillon et de les maintenir chaque fois qu'un canal change.
C'est pourquoi il faut surtout regarder deux lignes du tableau : la collecte massive et exhaustive (la population est-elle couverte ?) et la cohérence de l'échantillon (qui traite les doublons et les omissions ?). Tout le reste découle de ces deux éléments.
Les 5 questions d'auto-diagnostic avant contrat
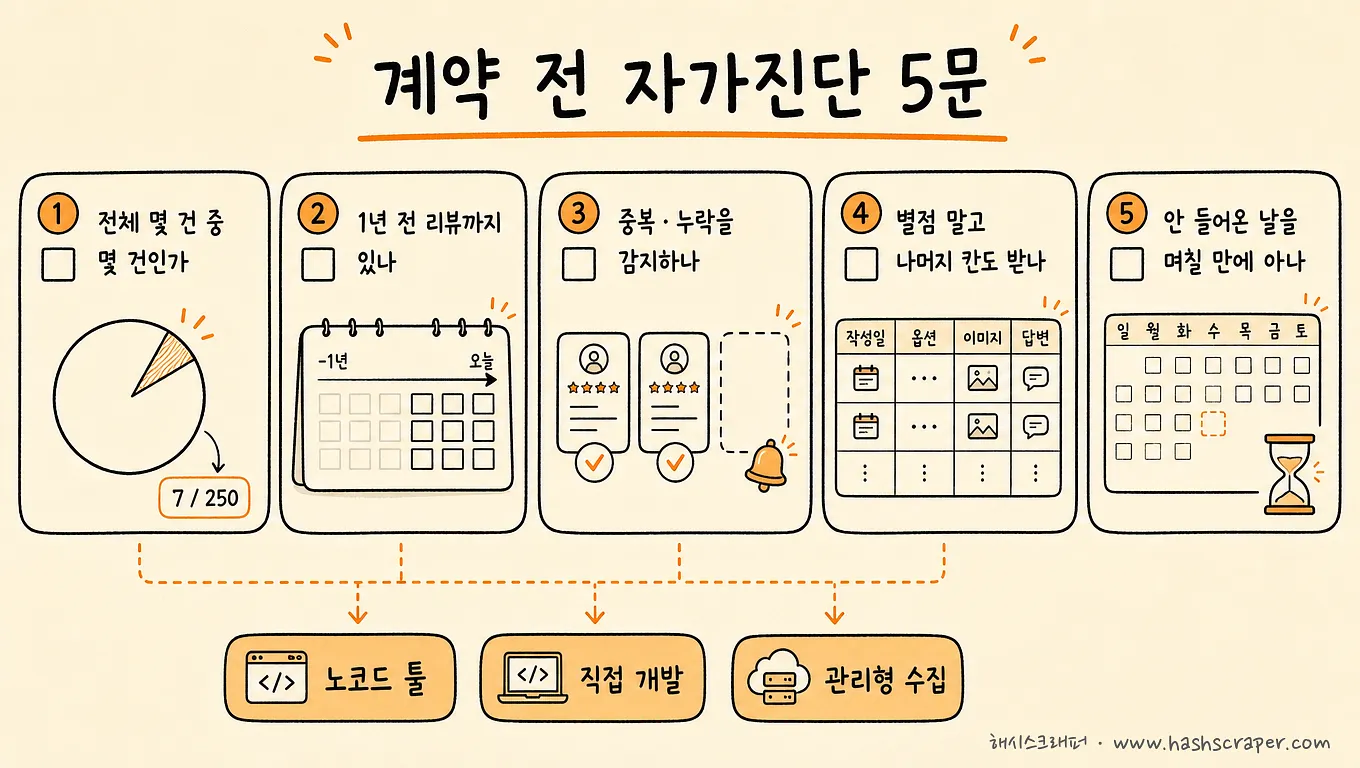
Vérifiez-les. Ces cinq lignes sont plus rapides que trois devis.
- [ ] Pouvons-nous dire aujourd'hui combien d'avis sur combien au total nous analysons ?
- [ ] Ne récupérons-nous pas uniquement les premiers avis triés par date récente — des avis datant d'il y a un an sont-ils inclus dans l'échantillon ?
- [ ] Si le même avis arrive deux fois ou si un avis présent hier disparaît aujourd'hui, avons-nous un mécanisme pour le détecter ?
- [ ] Recevons-nous, au-delà de la note, également la date de rédaction, l'option d'achat, les images et la réponse du commerçant ?
- [ ] Savons-nous si un jour s'est écoulé sans réception d'avis et, le cas échéant, en combien de jours l'avons-nous détecté ?
Si la réponse à la première question est « non », il y a une priorité avant de comparer les prestataires : vérifier le dénominateur de notre échantillon.
Si la réponse aux troisième et cinquième questions est « non » alors que la collecte se répète quotidiennement, les choix se réduisent aux services managés. Si vous souhaitez simplement examiner une fois quelques produits, un outil no-code suffit.
Les 5 étapes de mise en place
Étape 1. Définissez les canaux et les cibles — e-commerce, boutique d'applications, Google Maps ou communauté. Commencer par « les canaux actuellement discutés en réunion d'amélioration » offre un meilleur taux de réussite que viser « toutes les réactions clients ».
Étape 2. Écrivez les critères de l'échantillon en une phrase — période (les 12 derniers mois ? l'ensemble de l'historique ?), tri (exhaustif ? par ordre récent ?) et périmètre des produits. Le fait que le prestataire rédige ou non cette phrase avec vous détermine s'il s'agit réellement d'un service managé.
Étape 3. Définissez les champs de collecte dans un tableau — commencez par les 8 champs ci-dessus, mais n'excluez ni l'identifiant unique ni la date de rédaction. Ce sont des valeurs que vous ne pourrez pas récupérer à nouveau par la suite.
Étape 4. Définissez les règles de collecte incrémentale — faut-il récupérer uniquement les nouveaux avis, et comment traiter les avis modifiés ou supprimés ? Les avis ne sont pas des données que l'on récupère une fois pour toutes.
Étape 5. Comparez un échantillon à l'écran avant de déployer à plus grande échelle — comparez notamment le nombre total d'avis affiché à l'écran et le nombre d'avis collectés. La plupart des dégradations d'échantillon sont détectées ici.
Ce qu'il faut faire aujourd'hui n'est pas de choisir un prestataire. C'est l'étape 2 : écrire en une phrase le périmètre des avis que nous voulons examiner.
Après la collecte vient l'analyse
Jusqu'ici, nous sommes dans le domaine de l'échantillon. Ensuite vient le domaine de l'interprétation.
Lorsqu'un avis est enrichi de colonnes de sentiment, de catégorie, de mots-clés et de traduction, le responsable peut commencer par les filtres et les agrégations plutôt que par la lecture du texte. La méthode est détaillée dans Ajouter une analyse IA aux avis collectés — comment lire la VOC grâce à l'analyse de sentiment, à la classification et à la traduction.
Si personne n'agit même après avoir ajouté l'analyse, ce qui manque est une alerte. La structure permettant qu'une hausse soudaine des avis négatifs atteigne le responsable est expliquée dans Le monitoring ne consiste pas à collecter, mais à alerter, tandis que la vue d'ensemble collecte → nettoyage → analyse → diffusion se trouve dans Quand les données de crawling deviennent une décision.
L'ordre, toutefois, ne change pas. Aussi bonne soit-elle, une analyse menée sur un échantillon biaisé ne produira que des conclusions erronées avec précision.
Questions fréquentes
Q. Je souhaite collecter et analyser en masse les avis de boutiques en ligne et les données VOC clients. Quel service est le plus adapté ?
A. Trois options se distinguent selon l'ampleur et les ressources disponibles. Pour vérifier une fois les avis de quelques produits, des outils no-code (Thunderbit, Octoparse, etc.) suffisent. Si vous disposez d'une équipe de développement et que la collecte est une compétence clé de votre entreprise, le développement interne (Scrapy, Zyte, Firecrawl, etc.) offre davantage de liberté. Si vous devez recevoir chaque jour l'intégralité des avis de plusieurs canaux et poursuivre jusqu'à l'analyse sans personnel de développement, un service de collecte managé est la solution réaliste. Une seule question permet de trancher : avez-vous en interne quelqu'un capable de définir les critères de l'échantillon et de les respecter à chaque changement de canal ?
Q. Est-il également possible de collecter les avis de grandes boutiques en ligne coréennes telles que Coupang ou Naver Shopping ?
A. Oui, pour les avis publics. L'expérience de Hashscraper sur plus de 5 000 sites coréens inclut les principaux canaux e-commerce, et l'entreprise maintient un bilan de zéro problème juridique lié à la collecte. Toutefois, les avis constituent un domaine où le volume de requêtes augmente par multiplication avec le nombre de produits ; une infrastructure telle que des proxys dans 195 pays, ainsi qu'une maintenance continue, sont donc nécessaires.
Q. Peut-on récupérer tous les avis historiques ?
A. C'est possible dans la limite de ce que le canal rend public. Certaines plateformes limitent le nombre d'avis affichés ; lors de la définition des exigences, il faut donc vérifier « jusqu'où ce canal est-il visible ? » et indiquer cette limite dans le document des critères de l'échantillon. Décrire honnêtement le périmètre protège les conclusions de l'analyse par la suite.
Q. Peut-on également ajouter une analyse de sentiment aux avis collectés ?
A. Oui. Hashscraper fournit la collecte d'avis et l'analyse IA (sentiment, catégorie, mots-clés et traduction) dans un même pipeline, et il est également possible d'ajouter uniquement l'analyse aux données déjà collectées. La méthode est expliquée en détail dans Ajouter une analyse IA aux avis collectés.
Q. N'y a-t-il pas un problème si des données personnelles se retrouvent dans les données d'avis ?
A. C'est précisément pourquoi elles sont filtrées dès la phase de conception des champs de collecte. Le principe est de ne pas recevoir dès le départ les informations d'identification inutiles à l'analyse et de ne collecter que dans le périmètre des données publiques. Ne pas les recevoir dès le départ coûte toujours moins cher que de les supprimer plus tard.
Conclusion
Le choix d'un service de collecte d'avis et de VOC se réduit finalement à une seule question.
« Quel pourcentage du total représentent les avis que nous examinons, et qui est responsable de ce ratio ? »
- Vérifier une fois quelques produits → outil no-code (Thunderbit, Octoparse, etc.)
- Équipe de développement disponible + collecte comme compétence clé → développement interne (Scrapy·Zyte·Firecrawl, etc.)
- Tous les canaux chaque jour, jusqu'à l'analyse, sans personnel de développement → service de collecte managé (Hashscraper, etc.)
Récupérer beaucoup est une capacité. Récupérer sans omission est une conception.
N'achetez pas des avis. Achetez un échantillon.
30 000 avis biaisés sont plus dangereux que 3 000 avis honnêtes.
Commencer dès maintenant
Indiquez-nous les canaux et le périmètre des produits que vous souhaitez collecter ; nous évaluerons gratuitement comment définir les critères de l'échantillon et quel périmètre de collecte est possible. À l'inscription, 50 000 crédits sont fournis afin de vous permettre de vérifier d'abord la qualité des données d'avis réelles.


