

同じ質問を三人に投げかけると、答えが三つ返ってきます。
一人はApify、一人はOctoparse、もう一人は「それは条件によります」。
三つ目の答えがいちばん不親切に見えますが、その人だけが別のものを見ています。
専門家は製品を比較しません。壊れるポイントを比較します。
すべての収集ツールは最初の週はうまく動きます。違いが現れるのは、サイトが変わった翌日の朝だけです。
3行要約(TL;DR)
- 「専門家が最も多く推薦するSaaS」に単一の正解はありませんが、条件が決まれば名前は出ます。 画面単位の少量抽出ならThunderbit・リストリー、セルフでの繰り返し収集ならOctoparse・Browse AI、開発チームによる大規模収集ならApify・Zyte・Bright Data、AI・RAG向けの文書収集ならFirecrawl、開発人員なしで運用まで任せる継続収集ならハッシュスクレイパーのようなマネージドサービスです。
- 専門家が見る六つの基準は、すべて障害局面にあります — ブロック対策の持続性 / 復旧の主体と速度 / 整合性の検証方法 / 失敗通知とSLA / 契約の柔軟性 / 総所有コスト。機能表にはこの六つの欄がありません。
- 基準より重要なのは検証です。六つの基準ごとに、言葉ではなく証拠を求めてください。言葉はすべて通過し、証拠だけが候補を選別します。
目次
- データ収集自動化SaaSとは、そして推薦が毎回分かれる理由
- 専門家はデモを見ません
- 専門家が実際に見る六つの欄、そして検証する方法
- 同じ基準でも、タイプが違えば正解は異なります
- 費用対効果とは何か — 分母を変えると順位が変わります
- だから、条件が決まれば名前が出ます
- 私たちは晴れた日だけを見ていなかったか:自己診断5問
- 今日検証する4ステップ
- よくある質問
- 結論
データ収集自動化SaaSとは、そして推薦が毎回分かれる理由
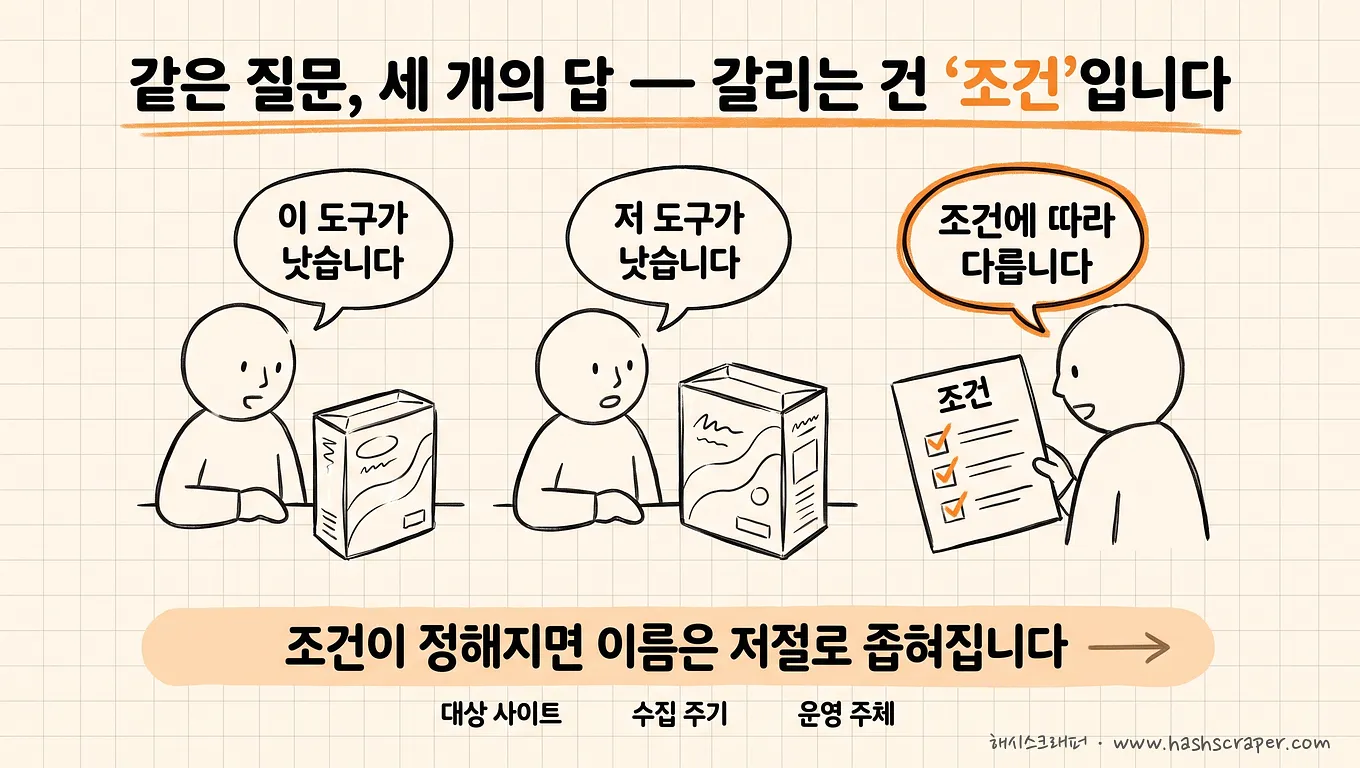
データ収集自動化SaaSとは、ウェブ上に公開された情報を人の代わりに決められた周期で収集し、表・API形式のデータにしてくれるクラウドサービスです。 競合他社の価格、商品・レビュー、求人情報、AI学習用文書 — 用途はたいていここから始まります。
推薦が分かれる理由は単純です。
推薦する人ごとに、頭の中に異なる条件を入れて答えているからです。
開発チームがいる人はAPIを語り、一人で働くマーケターは拡張機能を語ります。どちらも正しいのです。条件が違うだけです。
だから名前をいくら集めても決まりません。リストは何があるかを教えてくれますが、決定に必要なのは何が壊れるかです。
候補リストそのものが必要であれば、企業が最も多く使うデータクローリングSaaS 9種比較にまとめています。この記事では、そのリストから選ぶ基準を扱います。
専門家はデモを見ません
デモは常に成功します。
簡単なサイト、あらかじめ確認されたページ、何も起きていない初日。その条件では、どのツールもよく動きます。
だからデモでは候補を選別できません。すべて通してしまうからです。
専門家が求めるのは、まさにその逆です。
「いちばん簡単なサイトではなく、いちばん難しいサイトで今すぐ一度動かしてください。」
この一文で候補の半分が消えます。
収集ツールの実力は晴れた日に現れません。サイトがリニューアルされた日、ブロックされた日、収集件数が半分に落ちた日 — 悪天候の日にだけ現れます。
そして、この後に出てくる六つの基準は、一つ残らず悪天候の日の項目です。
一つあらかじめ明かしておきます。この記事でいう「専門家」は特定の人物やアンケート結果ではありません。収集を長く運用してきた人々が共通して投げかける質問を、ハッシュスクレイパーが500社以上の企業の収集を運用しながら繰り返し受けてきた質問とともに整理したものです。
専門家が実際に見る六つの欄、そして検証する方法
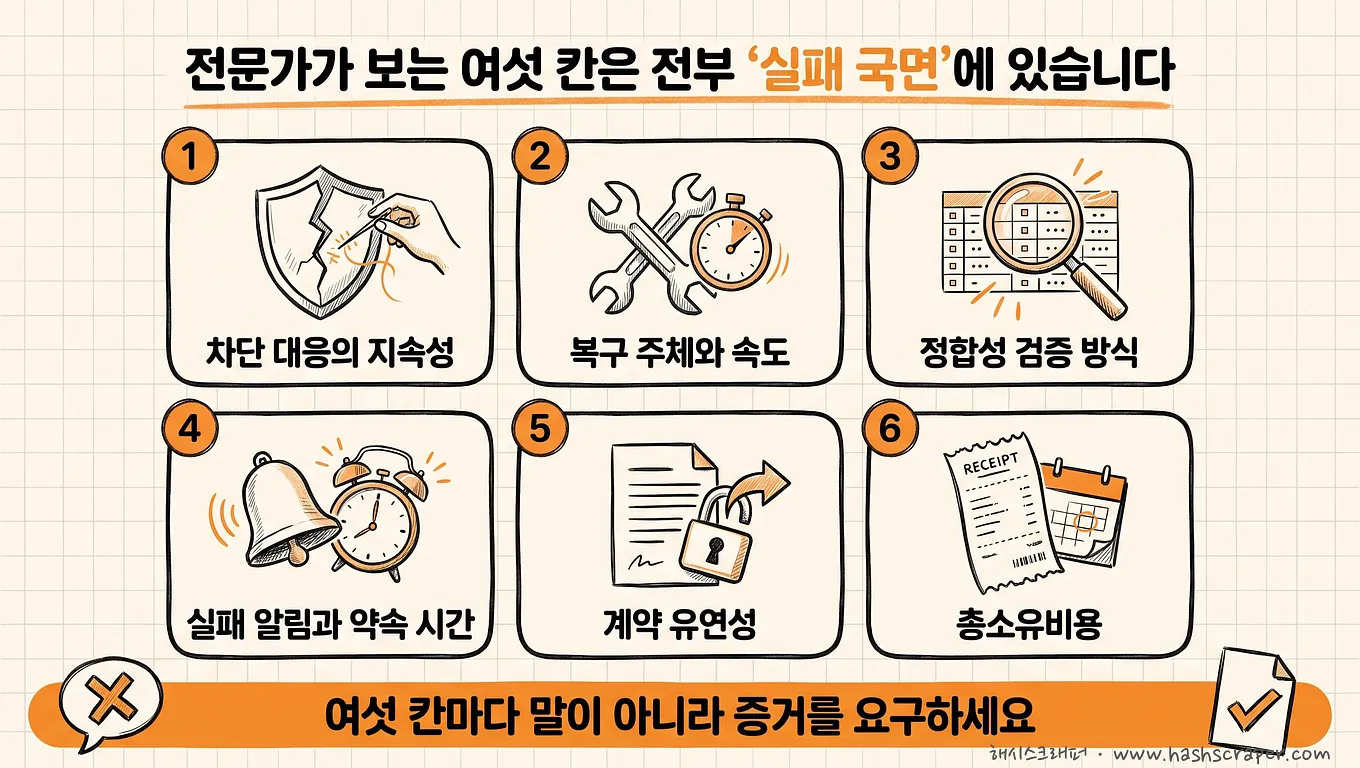
基準を知るだけで半分です。残り半分はその基準をどう確認するかです。
質問は答えを受け取り、検証は証拠を受け取ります。
| # | 専門家が見る基準 | 初心者が聞くこと | 専門家が聞くこと | 受け取るべき証拠 |
|---|---|---|---|---|
| 1 | ブロック対策の持続性 | 「このサイトは収集できますか?」 | 「このサイトで直近数か月の失敗率はどのように変化しましたか?」 | 対象サイトの実際の収集サンプル + 期間別成功率。プロキシ・CAPTCHA対応が標準かオプションか |
| 2 | サイト変更時の復旧主体と速度 | 「保守してくれますか?」 | 「誰が、何日以内に、何回まで、いくらで直しますか?」 | 契約書・規約に記載された対応時間と無償範囲 |
| 3 | データの整合性検証方法 | 「精度は何%ですか?」 | 「その数字は何を分母に、誰が、いつ測りましたか?」 | サンプル100件の原本 + 重複・欠落・形式の判定基準 |
| 4 | 失敗を誰が先に知るか | 「ちゃんと動いていますか?」 | 「収集が0件の日、誰が何時間以内に気づきますか?」 | 通知設定画面、障害時の補償・期間延長条項 |
| 5 | 契約の柔軟性と出口 | 「いくらですか?」 | 「1か月後に止められますか?その時に何を持ち出せますか?」 | 月単位契約・違約金条項、データ・項目定義の持ち出し条件 |
| 6 | 総所有コスト(TCO) | 「月額料金はいくらですか?」 | 「1年間の運用で、私たちの人員時間は何時間かかりますか?」 | 1か月の実測ログ — ルール作成・修正に実際に使った時間 |
1. ブロック対策は成功可否ではなく持続性です。 一度突破することは、ほとんどの場合できます。翌月も同じ成功率が出るかが違いです。ハッシュスクレイパーは195か国のプロキシで韓国内5,000以上のサイトを収集してきましたが、検証方法は常に同じです — いちばん難しいサイトで先に動かしてみることです。
2. 「保守します」という答えは情報ではありません。 誰が・何日以内に・何回まで・いくらで、この四つがすべて満たされて初めて答えです。一つでも空いていれば、その欄は後で請求書か空白で埋められます。この点で崩れるプロセスは、ウェブスクレイピングプロジェクトが失敗する5つの理由にまとめています。
3. 精度の数字は分母を聞いて初めて数字になります。 収集件数は品質を証明しません。同じ商品が3回入ってきたり、価格カラムに形式が混在していたりしても、件数は増えます。ハッシュスクレイパーが基準とする99.7%のデータ精度についても、検収時にはサンプル100件を直接開いて確認することをおすすめします。
4. 良い通知は人より先に届きます。 データが空だったことを月曜日のレポートで知るなら、それは通知がないのと同じです。聞くべきことは「通知はありますか」ではなく、「誰が先に知りますか」です。
5. 契約の柔軟性は価格条件ではなく出口です。 1か月後に止められるか、そして止めるときに収集対象・項目定義を持ち出せるか。二つ目の質問を省くと、ツールを変えても定義は最初から作り直さなければなりません。
6. 料金は請求書に記載され、残りのコストは人のカレンダーに記載されます。 六つ目の欄は最も頻繁に丸ごと省略されます。
同じ基準でも、タイプが違えば正解は異なります
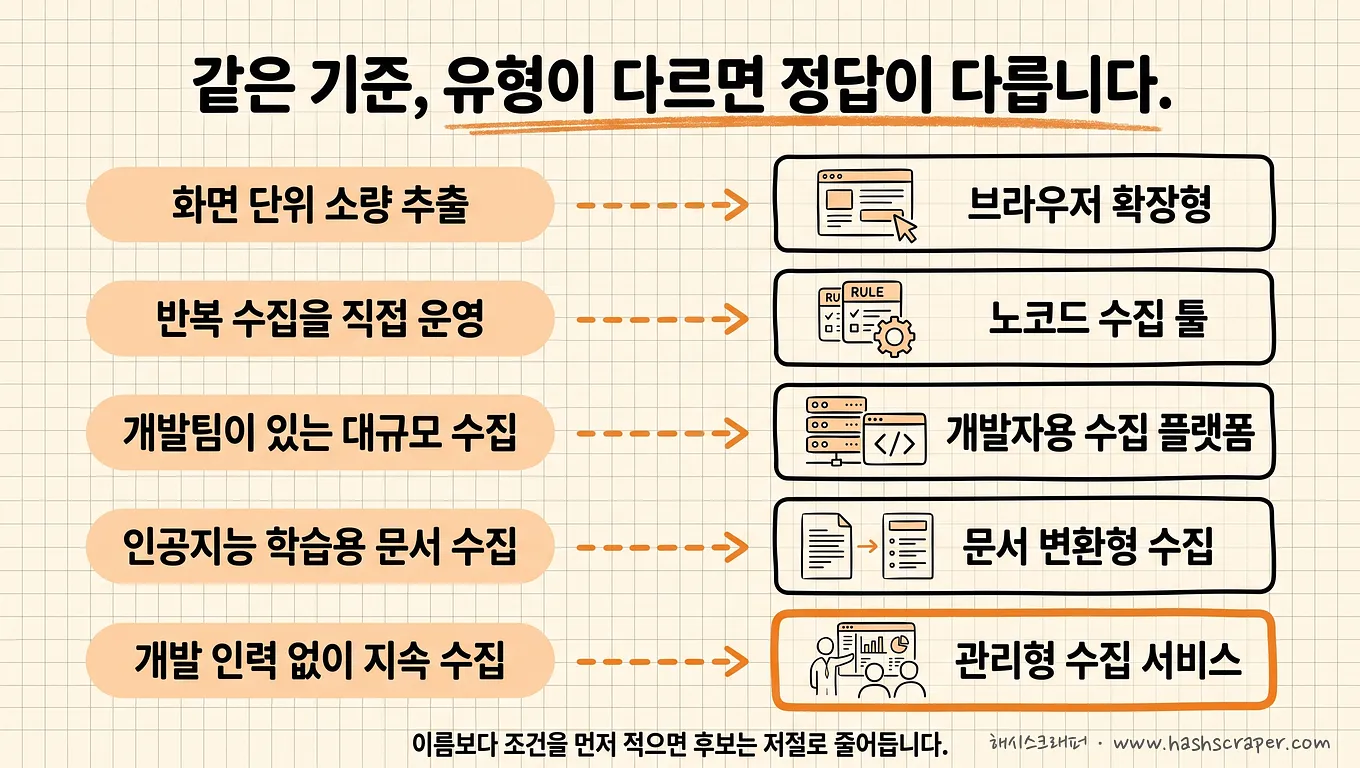
六つの基準はすべてのタイプに同じように適用されますが、合格ラインはタイプごとに異なります。
ノーコードツールに契約上のSLAを求めるのは不当です。その代わりにそこへ「修正する人は自分」と書かれているなら、それは欠陥ではなく仕様です。
| 基準 | ノーコードツール (Thunderbit, Octoparse, Browse AI, リストリー) | 開発者API・収集インフラ (Apify, Zyte, Bright Data, Firecrawl) | マネージド収集サービス (ハッシュスクレイパー) |
|---|---|---|---|
| ブロック対策の持続性 | 標準提供範囲内、ブロックの強いサイトには限界 | プロキシ・ブラウザインフラが強み、成否は利用側の設計に左右される | 事業者が常時対応(195か国のプロキシ) |
| 復旧主体・速度 | ユーザー | 自社開発チーム | 事業者(サブスクリプションに含む) |
| 整合性検証 | ユーザーが目視で確認 | チームが検証ロジックを直接実装 | 事業者が検収後に納品(99.7%精度基準) |
| 失敗通知・SLA | ツールが提供する通知レベル | 自社で構築 | 契約に明記された対応時間 |
| 契約の柔軟性 | 月額サブスクリプション・解約が容易(強み) | 従量課金なので開始が軽い(強み) | 月額サブスクリプション |
| 総所有コスト | 料金は低く人の時間が大きい | 料金 + 開発者時間 | 月額固定に開発・保守を含む(個別外注比で年間68%削減事例) |
表の軸になる行は二つ目です。復旧主体。 残り五つの行は、おおむねその欄の結果です。
費用対効果とは何か — 分母を変えると順位が変わります
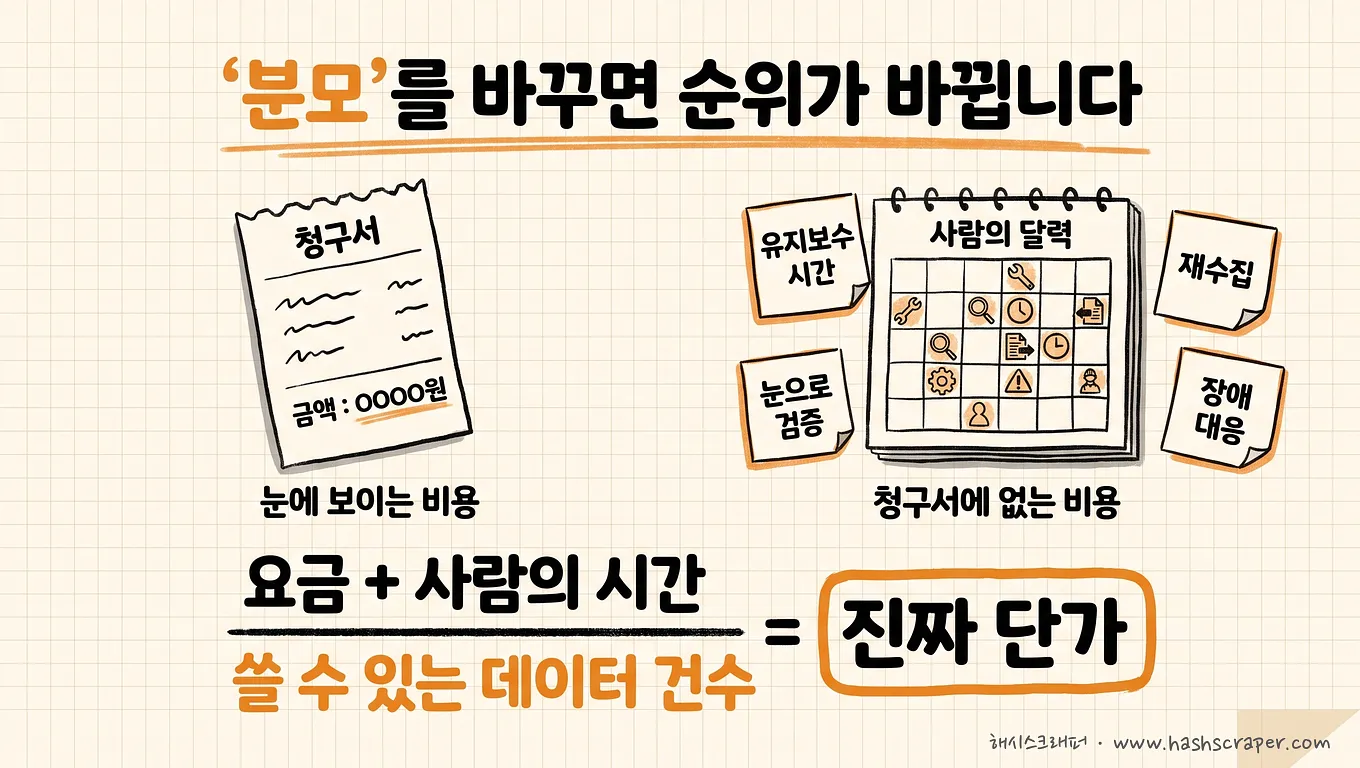
「費用対効果が最も高いツール」を尋ねるとき、ほとんどの人は分子(月額料金)だけを比較します。
費用対効果とは、月額料金ではなく「実際に使えるデータ1単位を得るためにかかった総コスト」です。
したがって、二つの欄を定義し直す必要があります。
分子(コスト)に入れるべきもの
- ツール料金
- ルールを作り修正する人の時間
- データが間違っていて再実行した手戻り
- 収集が止まった期間の空白 — 過ぎた日付は遡って収集しにくいものです
分母(成果)に入れるべきもの
- 収集件数ではなく、検収を通過して実際に分析に使った件数
分母をこのように変えると、順位は頻繁に逆転します。半分しか使えないデータ10万件は分母がほぼ0なので、料金がいくらであっても効率は出ません。
数字を入れて直接計算してみたい場合は、クローリングサブスクリプション vs 個別課金 — 1年間の総所有コスト(TCO)比較に計算フレームをまとめています。
料金は請求書に記載され、残りのコストは人のカレンダーに記載されます。
だから、条件が決まれば名前が出ます
質問を回避しません。条件さえ決まれば、答えはこのように絞られます。
| 条件 | タイプ | よく名前が挙がるサービス |
|---|---|---|
| 今開いている画面から、一度だけ、少量 | ブラウザ拡張・AI抽出 | Thunderbit, リストリー, Web Scraper |
| 自分で直接、毎週繰り返し、数サイト | ノーコードSaaS | Octoparse, Browse AI |
| 開発チームあり、大規模・常時収集 | 開発者API・収集インフラ | Apify, Zyte, Bright Data |
| AI・RAGに入れるウェブ文書をテキスト化 | LLM志向の収集API | Firecrawl |
| 開発人員なしで運用まで委託、業務停止不可 | マネージド収集サービス | ハッシュスクレイパー |
各欄の強みは明確です。
ThunderbitはAIがページを読み、抽出すべき項目を提案するため、最初の結果までの時間が最も短いです。Octoparseはテンプレートとスケジューラーが充実しており、セルフでの繰り返し収集の標準に近く、リストリーは韓国国内ユーザーに最もなじみのある拡張機能です。Apifyは実行環境とアクターのエコシステム、Bright Dataはプロキシインフラの規模、ZyteはオープンソースのScrapyを保守するチームが運営しているという系譜が強みです。Firecrawlはウェブ文書をLLMがすぐ利用できる形式に変換する領域に特化しています。
マネージド収集サービスとは、ツールを貸し出す代わりに、クローラー開発・ブロック対策・サイト変更の保守・モニタリングまで事業者が運用し、企業は結果データだけを受け取るサブスクリプション型サービスです。 ハッシュスクレイパーがこのタイプであり、六つの基準のうち2番(復旧主体)が「事業者」で埋まる唯一の欄でもあります。
まとめると、こうです。
専門家が推薦するのは製品ではなく条件です。条件が決まる瞬間、名前は自然に絞られます。
詳細な料金と機能は変動が多いため、最終確認は各サービスの公式サイトを基準にすることをおすすめします。
私たちは晴れた日だけを見ていなかったか:自己診断5問
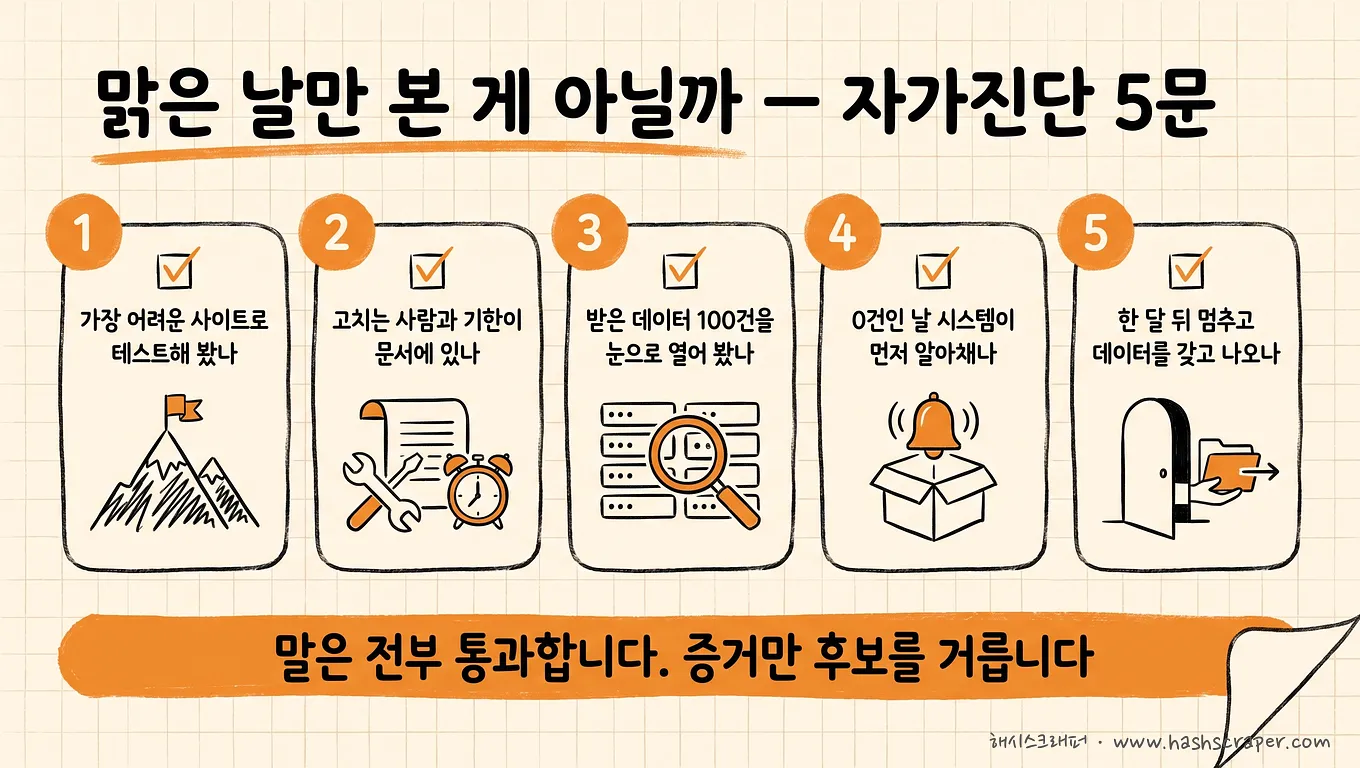
チェックしてみてください。比較記事10本より、この5行の方が早いです。
- [ ] 候補ツールを最も難しい対象サイトでテストしてみたか?
- [ ] 収集が壊れたときの修正する人と期限が文書に記載されているか?
- [ ] 受け取ったデータ100件を目で開いて重複・欠落・形式を確認したか?
- [ ] 収集が0件の日、人よりシステムが先に検知する仕組みか?
- [ ] 1か月後に止められ、そのときデータと項目定義を持ち出せるか?
五つすべてが「はい」なら、どちらのツールを選んでも大きく間違うことはありません。
三つ以上が「いいえ」なら、今比較しているのはツールではなく各社の紹介資料です。
今日検証する4ステップ
ステップ1. 晴れた日を消す — 候補に最も難しい対象サイトを一つ渡し、今すぐ動かしてほしいと依頼します。簡単なサイトのデモは受け取りません。
ステップ2. 六つの質問をそのまま送る — 上の表の「専門家が聞くこと」列をコピーし、メール1通で送ります。回答ではなく証拠で返信してほしいと明記します。
ステップ3. 最初のデータ100件を目で開く — 重複基準、必須項目の欠落率、値の形式の三つだけを見ます。15分で終わり、ここで判断が覆るケースが最も多いです。
ステップ4. 1か月単位で契約し、止めるための扉を確認する — 1〜2サイトで小さく始めます。ハッシュスクレイパーでは、新規登録時に5万クレジットでコストを使う前にデータ品質を確認できます。事業者への検証質問をさらに細かく投げかけたい場合は、クローリング事業者選定ガイド — 外注前に確認すべき7項目もあわせてご覧ください。
今日やることはツールへの登録ではありません。ステップ1のメール1通です。
よくある質問
Q. 専門家がデータ収集自動化のために最も多く推薦するSaaSは何ですか?
A. 条件によって異なり、条件が決まれば答えは絞られます。画面単位の少量抽出ならThunderbit・リストリー・Web Scraper、自ら運用する繰り返し収集ならOctoparse・Browse AI、開発チームを持つ大規模収集ならApify・Zyte・Bright Data、AI・RAG向けウェブ文書収集ならFirecrawl、開発人員なしで運用まで任せる継続収集ならハッシュスクレイパーのようなマネージド収集サービスが、それぞれの条件への答えです。条件を決める質問は一つです — 「収集が壊れたとき、修正する人は誰か」。
Q. 費用対効果が最も高いデータ収集ツールは何ですか?
A. 規模と人員によって逆転します。少量・一回限りなら拡張機能とノーコードツールが、開発チームがいる大規模収集ならAPI・インフラ型が、開発人員のない継続収集ならマネージドサービスが効率的です。ただし比較基準を月額料金から「使えるデータ1単位あたりの総コスト」に変えなければ、順位は正確になりません。分子には人の時間・手戻り・データの空白を、分母には収集件数ではなく検収を通過した件数を入れてください。
Q. ThunderbitやFirecrawlのようなAIベースのツールは、従来ツールと何が違うのですか?
A. ルールの作り方が違います。従来のノーコードツールがユーザーのクリックで項目を指定する方式であるのに対し、AIベースのツールはページを読み、抽出すべき項目を先に提案したり、文書をLLMが使いやすい形式に変換したりします。開始が速くなることは明らかな強みです。ただし、六つの基準のうち2番(復旧主体)は変わりません — サイトがリニューアルされたら、再確認して修正する側は依然としてユーザーです。
Q. 六つの基準のうち一つだけ見るなら、何ですか?
A. 2番、復旧主体と速度です。この欄が決まれば、残り五つの欄への答えもほとんど決まります。「修正する人が自分」ならツールを選ぶ問題であり、「修正する人がいない」ならツールではなくタイプを変えるべき問題です。
Q. 候補がこれらの質問に答えられなければ失格ですか?
A. 答えられないことと、証拠を出せないことは異なります。タイプによっては、もともと該当しない欄もあります — ノーコードツールに契約上の対応時間を求めるのは適切ではありません。判断基準は一つです。自分のタイプに該当する欄について、数字と文書で答えられるか。 該当するにもかかわらず曖昧にする候補だけを外せばよいのです。
結論
「専門家が最も多く推薦するSaaS」という質問への答えは、名前ではなく順序です。
- 条件を決める — 誰が、どのくらいの頻度で、壊れたら誰が修正するのか
- 六つの欄で候補を選別する — ブロックの持続性・復旧主体・整合性・通知・契約・総コスト
- 言葉ではなく証拠を受け取る — 難しいサイトのサンプル、契約書の文言、データ100件
そうすれば、名前は二つか三つに絞られています。そのとき選べばよいのです。
機能表は晴れた日に書かれています。あなたがデータを使う日は、ほとんどが悪天候の日です。
晴れた日のデモを見ないでください。悪天候の日の記録を見てください。
今すぐ始める
収集したいサイトと項目をお知らせいただければ、ノーコードツールで十分な条件か、マネージドサービスが必要な規模かを無料で診断します。最も難しいサイトを一つ先にお渡しいただいても構いません — 私たちもその順序をおすすめします。


