

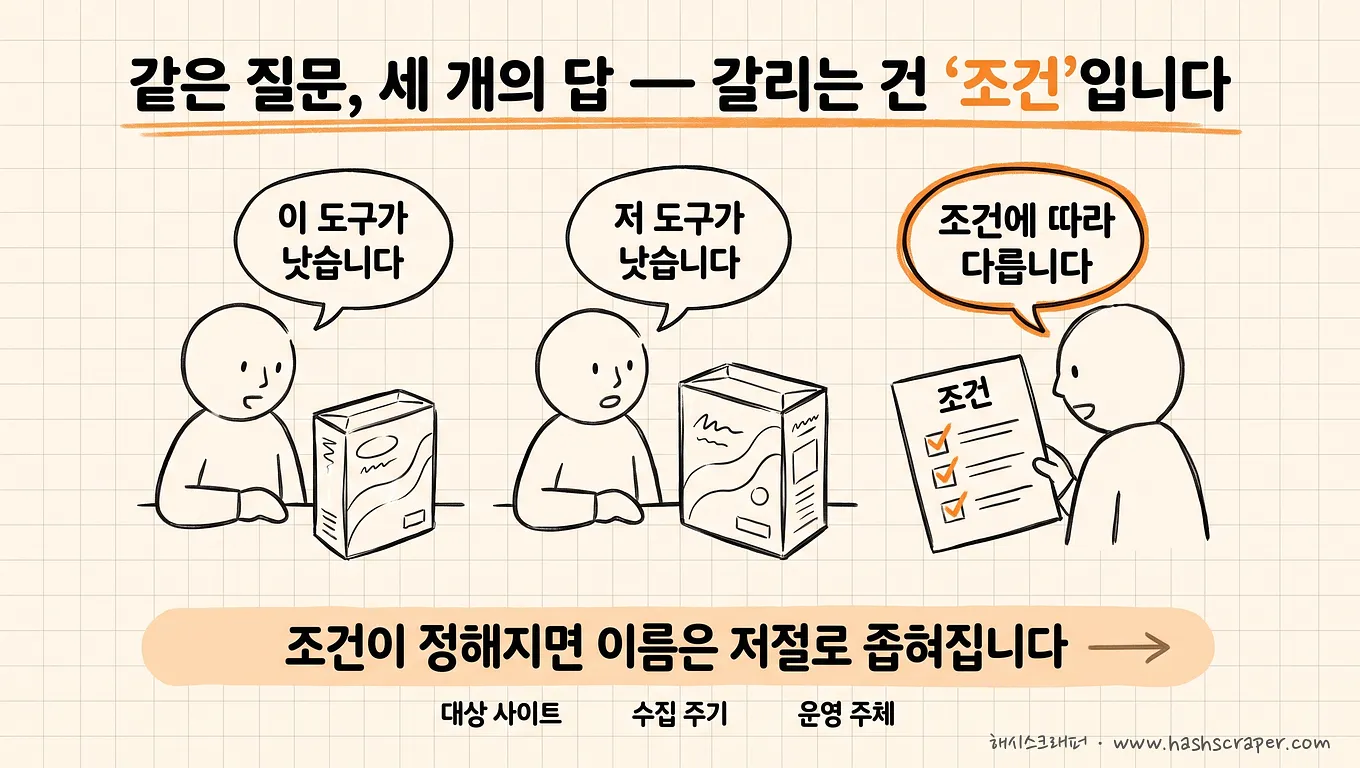
Si haces la misma pregunta a tres personas, obtendrás tres respuestas.
Una dice Apify, otra dice Octoparse, y la tercera dice: "Depende de las condiciones".
La tercera respuesta parece la menos elaborada, pero esa persona es la única que está mirando algo distinto.
Los expertos no comparan productos. Comparan los puntos donde se rompen.
Todas las herramientas de recopilación funcionan bien durante la primera semana. La diferencia solo aparece a la mañana siguiente de que cambia el sitio.
Resumen en 3 líneas (TL;DR)
- No existe una única respuesta para "el SaaS que más recomiendan los expertos", pero cuando se definen las condiciones, aparecen los nombres. Para extracciones pequeñas y puntuales desde pantalla: Thunderbit·Listly; para recopilación repetitiva autogestionada: Octoparse·Browse AI; para recopilación masiva de equipos de desarrollo: Apify·Zyte·Bright Data; para recopilar documentos destinados a IA·RAG: Firecrawl; y para recopilación continua donde se delega incluso la operación sin personal de desarrollo: servicios gestionados como Hashscraper.
- Los seis criterios que observan los expertos están todos en la fase de fallo — continuidad de la respuesta ante bloqueos / responsable y velocidad de recuperación / método de verificación de consistencia / alertas de fallos y SLA / flexibilidad contractual / coste total de propiedad. Estas seis columnas no aparecen en las tablas de funcionalidades.
- Más importante que los criterios es la verificación. Para cada uno de los seis criterios, exija pruebas, no palabras. Las palabras hacen que todos aprueben; solo las pruebas filtran a los candidatos.
Índice
- Qué es un SaaS de automatización de recopilación de datos y por qué las recomendaciones siempre difieren
- Los expertos no miran las demostraciones
- Las seis columnas que realmente miran los expertos y cómo verificarlas
- Mismos criterios, respuestas distintas según el tipo
- Qué significa eficiencia de costes: al cambiar el denominador cambia el ranking
- Por eso, cuando se definen las condiciones, aparecen los nombres
- ¿Hemos mirado solo los días soleados?: autodiagnóstico en 5 preguntas
- 4 pasos para verificar hoy
- Preguntas frecuentes
- Conclusión
Qué es un SaaS de automatización de recopilación de datos y por qué las recomendaciones siempre difieren
Un SaaS de automatización de recopilación de datos es un servicio en la nube que recoge periódicamente información pública de la web en lugar de una persona y la convierte en datos en formato de tabla o API. Precios de competidores, productos·reseñas, ofertas de empleo, documentos para entrenar IA: los usos normalmente empiezan aquí.
La razón por la que las recomendaciones difieren es simple.
Cada persona que recomienda responde con condiciones distintas en mente.
Quien tiene un equipo de desarrollo habla de APIs, y quien trabaja solo en marketing habla de extensiones. Ambos tienen razón. Solo tienen condiciones diferentes.
Por eso, reunir nombres una y otra vez no lleva a una decisión. Una lista indica qué existe, pero lo que necesita para decidir es qué se rompe.
Si necesita la lista de candidatos en sí, está recopilada en comparativa de 9 SaaS de crawling de datos más utilizados por las empresas. Este artículo aborda los criterios para elegir de esa lista.
Los expertos no miran las demostraciones
Las demostraciones siempre tienen éxito.
Un sitio fácil, una página revisada de antemano, el primer día en el que no ha sucedido nada. En esas condiciones, cualquier herramienta funciona bien.
Por eso las demostraciones no pueden filtrar candidatos. Porque todos aprueban.
Lo que exigen los expertos es exactamente lo contrario.
"En lugar del sitio más fácil, ejecútelo ahora una vez con el sitio más difícil."
Con esta sola frase desaparece la mitad de los candidatos.
La capacidad de una herramienta de recopilación no se revela en los días soleados. Solo se revela en los días malos: el día en que se rediseña el sitio, el día en que llega un bloqueo, el día en que el volumen recopilado cae a la mitad.
Y los seis criterios que aparecen más adelante son, sin excepción, elementos de los días malos.
Aclaremos algo de antemano. Los "expertos" de este artículo no son personas específicas ni los resultados de una encuesta. Son preguntas que suelen plantear quienes han operado recopilaciones durante mucho tiempo, organizadas junto con las preguntas que Hashscraper ha recibido repetidamente al operar la recopilación de más de 500 empresas.
Las seis columnas que realmente miran los expertos y cómo verificarlas
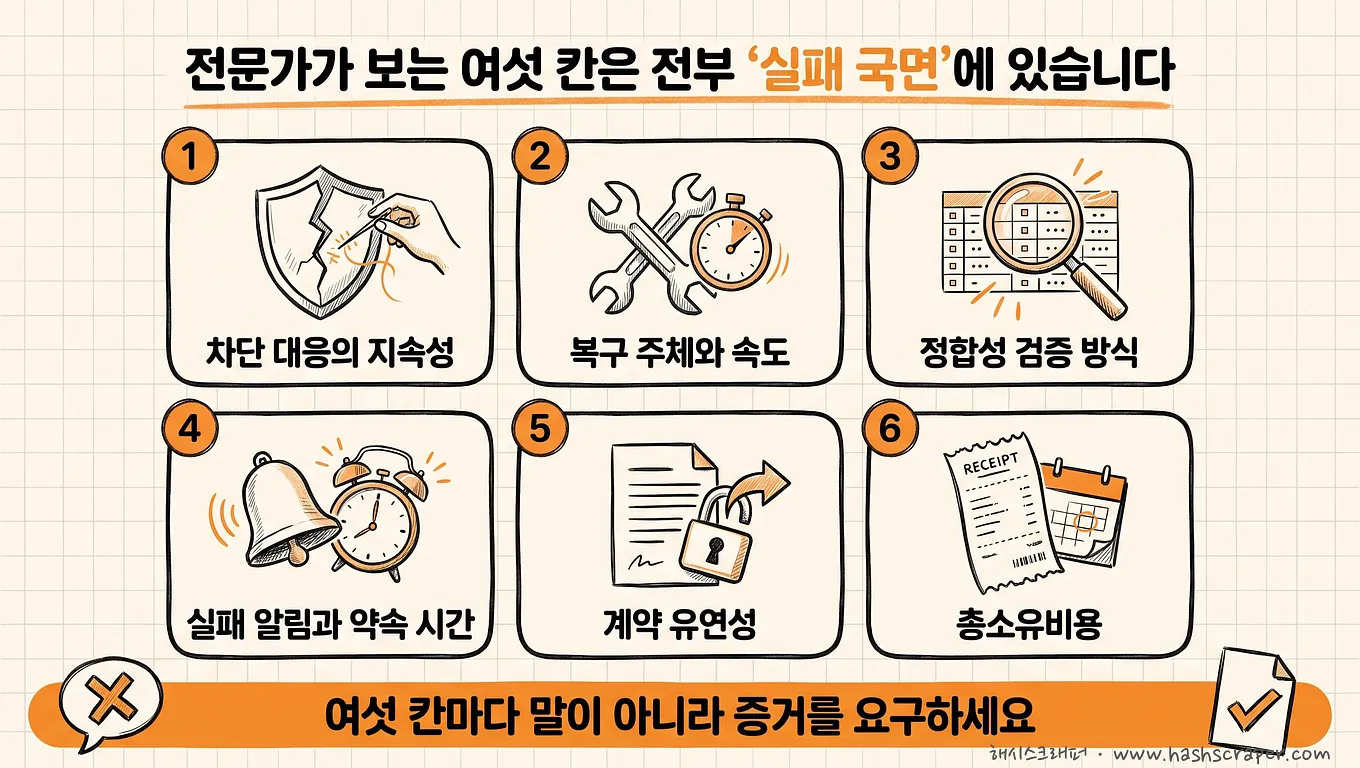
Conocer los criterios es solo la mitad. La otra mitad es cómo confirmar esos criterios.
Las preguntas reciben respuestas; la verificación recibe pruebas.
| # | Criterio que miran los expertos | Lo que pregunta un principiante | Lo que pregunta un experto | Prueba que debe recibir |
|---|---|---|---|---|
| 1 | Continuidad de la respuesta ante bloqueos | "¿Se puede recopilar este sitio?" | "¿Cómo ha variado la tasa de fallos en este sitio durante los últimos meses?" | Muestra real de recopilación del sitio objetivo + tasa de éxito por periodo. Si la respuesta a proxies·CAPTCHA está incluida por defecto o es una opción |
| 2 | Responsable y velocidad de recuperación cuando cambia el sitio | "¿Ofrecen mantenimiento?" | "¿Quién lo corrige, en cuántos días, cuántas veces y por cuánto?" | Tiempo de respuesta y alcance gratuito indicados en el contrato·términos |
| 3 | Método de verificación de la consistencia de los datos | "¿Cuál es el porcentaje de precisión?" | "¿Cuál es el denominador de esa cifra, quién la midió y cuándo?" | 100 registros originales de muestra + criterios de evaluación de duplicados·omisiones·formato |
| 4 | Quién se entera primero de un fallo | "¿Funciona bien?" | "Cuando hay 0 registros recopilados en un día, ¿quién se entera y en cuántas horas?" | Pantalla de configuración de alertas, cláusulas de compensación·extensión de plazo en caso de incidente |
| 5 | Flexibilidad contractual y salida | "¿Cuánto cuesta?" | "¿Puedo detenerlo dentro de un mes? ¿Y qué me llevo al hacerlo?" | Contrato mensual·cláusulas de penalización, condiciones de exportación de datos·definiciones de campos |
| 6 | Coste total de propiedad (TCO) | "¿Cuál es la tarifa mensual?" | "¿Cuántas horas de nuestro personal requiere operar esto durante un año?" | Registro real de un mes — tiempo realmente empleado en crear·reparar reglas |
1. La respuesta ante bloqueos no consiste en si tiene éxito, sino en su continuidad. La mayoría logra atravesarlo una vez. La diferencia es si mantiene la misma tasa de éxito el mes siguiente. Hashscraper ha recopilado datos de más de 5.000 sitios nacionales mediante proxies de 195 países, y el método de verificación siempre es el mismo: ejecutar primero el sitio más difícil.
2. La respuesta "ofrecemos mantenimiento" no es información. Deben estar completos los cuatro elementos: quién·en cuántos días·cuántas veces·por cuánto. Si falta aunque sea uno, esa columna acabará llenándose después con una factura o un vacío. El proceso de fracaso en este punto está recopilado en 5 razones por las que fracasan los proyectos de web scraping.
3. Una cifra de precisión solo se convierte en cifra cuando pregunta por su denominador. El número de registros recopilados no demuestra calidad. Aunque el mismo producto entre tres veces y la columna de precios contenga formatos mezclados, el volumen aumenta. Incluso con el estándar de 99,7% de precisión de datos de Hashscraper, recomendamos abrir directamente una muestra de 100 registros durante la inspección.
4. Una buena alerta llega antes que una persona. Si se entera de que faltan datos en el informe del lunes, es como no tener alertas. Lo que debe preguntar no es "¿hay alertas?", sino "¿quién se entera primero?".
5. La flexibilidad contractual no es una condición de precio, sino una salida. Si puede detenerlo dentro de un mes y, al detenerlo, puede llevarse las definiciones de los objetivos y campos de recopilación. Si omite la segunda pregunta, aunque cambie de herramienta tendrá que volver a crear las definiciones desde cero.
6. Las tarifas aparecen en la factura, y el resto de los costes aparece en el calendario de las personas. La sexta columna es la que más a menudo se omite por completo.
Mismos criterios, respuestas distintas según el tipo
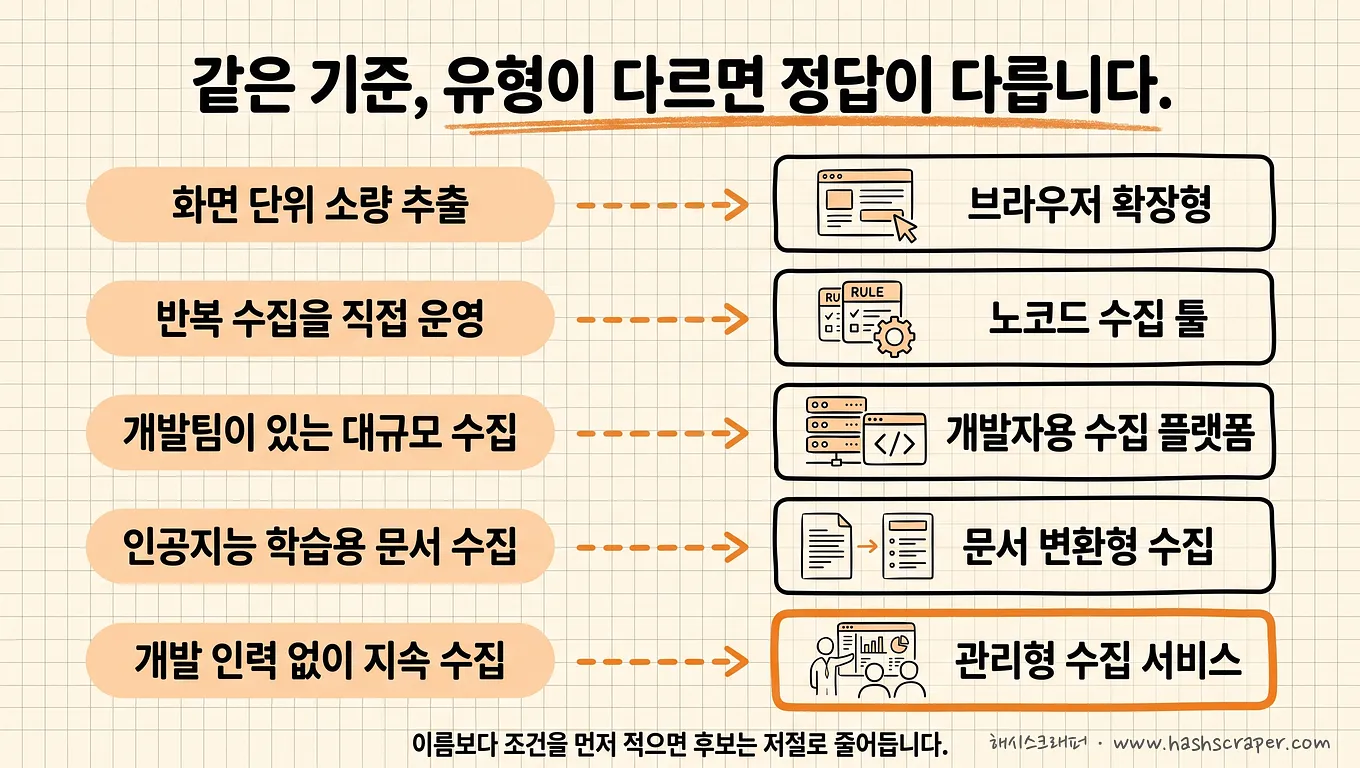
Los seis criterios se aplican por igual a todos los tipos, pero el umbral de aprobación es diferente según el tipo.
No es razonable exigir un SLA contractual a una herramienta no-code. En cambio, si allí figura "la persona que lo corrige soy yo", eso no es un defecto, sino una especificación.
| Criterio | Herramientas no-code (Thunderbit, Octoparse, Browse AI, Listly) | API para desarrolladores·infraestructura de recopilación (Apify, Zyte, Bright Data, Firecrawl) | Servicio de recopilación gestionado (Hashscraper) |
|---|---|---|---|
| Continuidad de respuesta ante bloqueos | Dentro del alcance básico proporcionado; limitaciones en sitios con bloqueos fuertes | La infraestructura de proxies·navegadores es su fortaleza; el éxito depende del diseño del usuario | El proveedor responde de forma continua (proxies de 195 países) |
| Responsable·velocidad de recuperación | Usuario | Equipo de desarrollo propio | Proveedor (incluido en la suscripción) |
| Verificación de consistencia | El usuario verifica visualmente | El equipo implementa directamente la lógica de validación | El proveedor entrega tras inspección (estándar de 99,7% de precisión) |
| Alertas de fallos·SLA | Nivel de alertas que ofrece la herramienta | Se construye directamente | Tiempo de respuesta especificado en el contrato |
| Flexibilidad contractual | Suscripción mensual·cancelación fácil (fortaleza) | La facturación por uso permite empezar fácilmente (fortaleza) | Suscripción mensual |
| Coste total de propiedad | Tarifas bajas y mucho tiempo de personal | Tarifas + tiempo de desarrolladores | Desarrollo·mantenimiento incluidos en tarifa fija mensual (caso de reducción anual del 68% frente a externalización individual) |
La fila clave de la tabla es la segunda. El responsable de la recuperación. Las otras cinco filas son, en gran medida, el resultado de esa columna.
Qué significa eficiencia de costes: al cambiar el denominador cambia el ranking
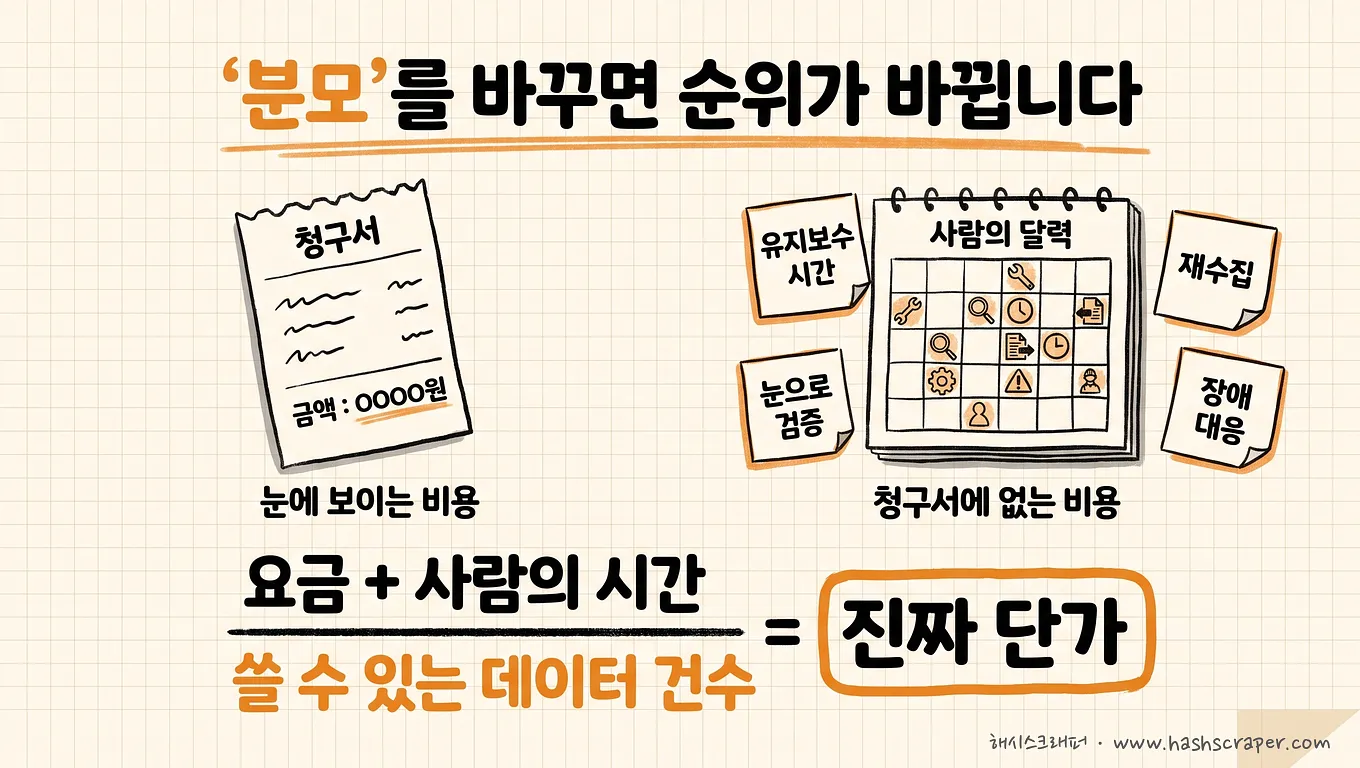
Cuando se pregunta por "la herramienta con mejor eficiencia de costes", la mayoría compara solo el numerador: la tarifa mensual.
La eficiencia de costes no es la tarifa mensual, sino el 'coste total necesario para obtener una unidad de datos realmente utilizables'.
Por eso hay que redefinir dos columnas.
Qué debe incluirse en el numerador (costes)
- Tarifa de la herramienta
- Tiempo de las personas que crean y corrigen reglas
- Retrabajo por datos incorrectos que requieren una nueva ejecución
- El vacío durante el periodo en que se detuvo la recopilación — es difícil recopilar retrospectivamente fechas ya pasadas
Qué debe incluirse en el denominador (resultados)
- No el número de registros recopilados, sino el número que superó la inspección y se utilizó realmente en el análisis
Cuando cambia así el denominador, el ranking se invierte a menudo. 100.000 registros de datos que apenas se pueden usar tienen un denominador cercano a 0, por lo que no generan eficiencia sin importar cuál sea la tarifa.
Si desea introducir cifras y calcularlo directamente, el marco de cálculo está organizado en suscripción de crawling vs facturación individual — comparación del coste total de propiedad (TCO) de un año.
Las tarifas aparecen en la factura, y el resto de los costes aparece en el calendario de las personas.
Por eso, cuando se definen las condiciones, aparecen los nombres
No evitaremos la pregunta. Si solo se definen las condiciones, la respuesta se reduce así.
| Condición | Tipo | Servicios que suelen mencionarse |
|---|---|---|
| Una vez, en pequeña cantidad, desde una pantalla que está abierta ahora | Extensión de navegador·extracción con IA | Thunderbit, Listly, Web Scraper |
| Por mí mismo, cada semana, unos pocos sitios | SaaS no-code | Octoparse, Browse AI |
| Equipo de desarrollo disponible, recopilación masiva·continua | API para desarrolladores·infraestructura de recopilación | Apify, Zyte, Bright Data |
| Documentos web para introducir en IA·RAG como texto | API de recopilación orientada a LLM | Firecrawl |
| Delegar incluso la operación sin personal de desarrollo, sin posibilidad de interrupción del trabajo | Servicio de recopilación gestionado | Hashscraper |
Las fortalezas de cada columna son claras.
Thunderbit permite llegar al primer resultado en el menor tiempo porque la IA lee la página y sugiere los campos que se deben extraer. Octoparse cuenta con una amplia oferta de plantillas y programador, por lo que se aproxima al estándar de la recopilación repetitiva autogestionada, y Listly es la extensión más familiar para los usuarios nacionales. Apify destaca por su entorno de ejecución y ecosistema de actores, Bright Data por la escala de su infraestructura de proxies, y Zyte por el linaje de estar operado por el equipo que mantiene el proyecto open source Scrapy. Firecrawl está especializado en transformar documentos web en un formato que los LLM pueden consumir directamente.
Un servicio de recopilación gestionado es un servicio por suscripción en el que, en lugar de simplemente prestar una herramienta, el proveedor opera todo: desarrollo de crawlers·respuesta ante bloqueos·mantenimiento ante cambios del sitio·monitorización, mientras la empresa recibe solo los datos resultantes. Hashscraper pertenece a este tipo y es también la única columna en la que el criterio 2 de los seis, el responsable de recuperación, se completa como "proveedor".
En resumen:
Lo que recomiendan los expertos no es un producto, sino una condición. En el momento en que se define la condición, los nombres se reducen por sí solos.
Como los precios y funciones detallados cambian con frecuencia, recomendamos confirmar finalmente en los sitios oficiales de cada servicio.
¿Hemos mirado solo los días soleados?: autodiagnóstico en 5 preguntas
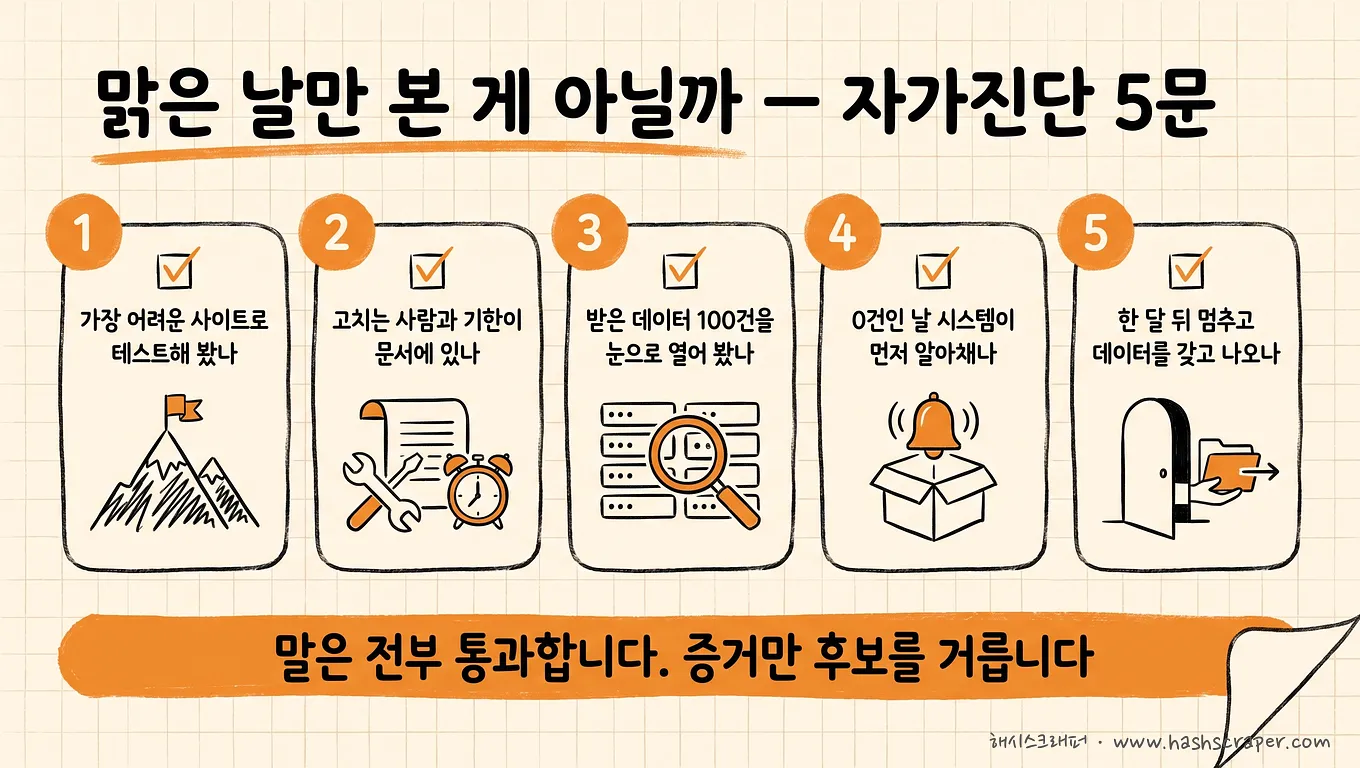
Revíselo. Estas cinco líneas son más rápidas que diez artículos comparativos.
- [ ] ¿Ha probado las herramientas candidatas con el sitio objetivo más difícil?
- [ ] Cuando se rompe la recopilación, ¿están documentados el responsable y el plazo de corrección?
- [ ] ¿Ha abierto visualmente 100 registros de los datos recibidos para comprobar duplicados·omisiones·formatos?
- [ ] En un día con 0 registros recopilados, ¿el sistema lo detecta antes que una persona?
- [ ] ¿Puede detenerlo dentro de un mes y, al hacerlo, llevarse los datos y las definiciones de los campos?
Si las cinco respuestas son "sí", no se equivocará mucho independientemente de la herramienta que elija.
Si tres o más son "no", lo que está comparando ahora no son herramientas, sino los materiales de presentación de cada empresa.
4 pasos para verificar hoy
Paso 1. Elimine los días soleados — entregue a cada candidato el sitio objetivo más difícil y pídale que lo ejecute ahora. No acepte demostraciones con sitios fáciles.
Paso 2. Envíe las seis preguntas tal cual — copie la columna "lo que pregunta un experto" de la tabla anterior y envíela en un correo. Especifique que desea una respuesta con pruebas, no solo respuestas.
Paso 3. Abra visualmente los primeros 100 registros — revise solo tres cosas: criterio de duplicados, tasa de omisión de campos obligatorios y formato de valores. Toma 15 minutos y es donde más a menudo se invierte la decisión.
Paso 4. Contrate por un mes y confirme la puerta de salida — empiece en pequeño con uno o dos sitios. Al registrarse, Hashscraper permite comprobar primero la calidad de los datos con 50.000 créditos antes de gastar dinero. Si desea plantear preguntas de verificación más detalladas al proveedor, consulte también guía para elegir una empresa de crawling — 7 cosas que revisar antes de externalizar la recopilación de datos.
La tarea de hoy no es registrarse en una herramienta. Es enviar el correo del paso 1.
Preguntas frecuentes
P. ¿Cuál es el SaaS que más recomiendan los expertos para la automatización de recopilación de datos?
R. Depende de las condiciones, y cuando estas se definen, la respuesta se reduce. Para extracciones pequeñas y puntuales desde pantalla: Thunderbit·Listly·Web Scraper; para recopilación repetitiva operada directamente: Octoparse·Browse AI; para recopilación masiva con equipo de desarrollo: Apify·Zyte·Bright Data; para recopilación de documentos web destinados a IA·RAG: Firecrawl; y para recopilación continua en la que se delega incluso la operación sin personal de desarrollo: servicios gestionados como Hashscraper. Solo hay una pregunta que define las condiciones: "¿Quién corrige el problema cuando se rompe la recopilación?"
P. ¿Cuál es la herramienta de recopilación de datos con mejor eficiencia de costes?
R. El orden se invierte según la escala y el personal disponible. Para volúmenes pequeños·casos únicos, las extensiones y herramientas no-code son eficientes; para recopilación masiva con equipo de desarrollo, lo son las API·infraestructuras; y para recopilación continua sin personal de desarrollo, los servicios gestionados. Sin embargo, el ranking solo será preciso si cambia el criterio de comparación de la tarifa mensual al "coste total por unidad de datos utilizables". Incluya en el numerador el tiempo de las personas·retrabajo·vacíos de datos, y en el denominador no el volumen recopilado, sino los registros que superaron la inspección.
P. ¿En qué se diferencian las herramientas basadas en IA como Thunderbit o Firecrawl de las herramientas tradicionales?
R. La forma de crear reglas es distinta. Mientras las herramientas no-code tradicionales requieren que el usuario indique los campos mediante clics, las herramientas basadas en IA leen primero la página y sugieren los campos a extraer, o convierten documentos a un formato adecuado para que lo usen los LLM. Que el inicio sea más rápido es una clara fortaleza. Sin embargo, el criterio 2 de los seis, el responsable de recuperación, no cambia: cuando se rediseña el sitio, quien debe volver a comprobar y corregir sigue siendo el usuario.
P. Si tuviera que mirar solo uno de los seis criterios, ¿cuál sería?
R. El número 2: el responsable y la velocidad de recuperación. Cuando se define esta columna, las respuestas a las otras cinco la siguen en gran medida. Si "la persona que corrige soy yo", es un problema de elegir herramienta; si "no hay nadie que pueda corregirlo", es un problema en el que debe cambiar no la herramienta, sino el tipo de servicio.
P. ¿Un candidato queda descartado si no puede responder estas preguntas?
R. No poder responder y no poder aportar pruebas son cosas distintas. Según el tipo, hay columnas que ni siquiera aplican desde el principio: no corresponde exigir tiempos de respuesta contractuales a una herramienta no-code. El criterio de decisión es uno solo: ¿responde con cifras y documentos las columnas que corresponden a su tipo? Basta con eliminar a los candidatos que, aun correspondiéndoles, responden vagamente.
Conclusión
A la pregunta "¿cuál es el SaaS que más recomiendan los expertos?", la respuesta no es un nombre sino un orden.
- Defina las condiciones — quién, con qué frecuencia y quién corrige cuando se rompe
- Filtre a los candidatos con las seis columnas — continuidad ante bloqueos·responsable de recuperación·consistencia·alertas·contrato·coste total
- Reciba pruebas, no palabras — muestra de sitio difícil, texto contractual, 100 registros de datos
Después de eso, los nombres se habrán reducido a dos o tres. Entonces puede elegir.
Las tablas de funcionalidades fueron escritas para los días soleados. La mayoría de los días en que usted utiliza los datos son días malos.
No mire la demostración de un día soleado. Mire el historial de los días malos.
Empiece ahora mismo
Si nos indica el sitio y los campos que desea recopilar, diagnosticaremos gratuitamente si las condiciones son suficientes para una herramienta no-code o si necesita un servicio gestionado. También puede entregarnos primero el sitio más difícil: nosotros también recomendamos ese orden.


