

「レビュー3万件を収集しました。」
レポートにこの一文が入った瞬間、誰も次の質問をしません。
何件中の3万件ですか?
全体が4万件なら優れたデータです。全体が40万件なのに新着順で3万件だけ取得したのなら、それはVOCではなく 最近怒った人たちの集まりです。
同じ3万件。正反対の結論です。
レビュー分析が間違う原因は、たいてい分析ではありません。標本です。
3行要約 (TL;DR)
- レビュー・VOC収集サービスを選ぶ判断軸は、「どれだけ多く取得するか」ではなく「母集団のどこを、どのように切り取ったか」です。誤った価格はいずれ気づかれますが、欠けたレビューは画面にないため、最後まで気づかれません。
- レビューは価格・在庫とは性質が異なります。投稿時点が過去全体に散在し、ページネーションと並び順が収集中にも動き、重複と欠落が同時に発生します。「今の値を一つ正確に取得すること」ではなく、「過去全体を漏れなく確保すること」です。
- 方法は3つです。少量・単発の確認ならノーコードツール(Thunderbit、オクトパス(Octoparse)など)、開発チームがあるなら自社開発(Scrapy・Zyte・Firecrawlなど)、開発人材なしでチャネル全体のVOCを毎日受け取りたいならマネージド収集サービスです(Hashscraperは国内5,000以上のサイト収集経験、195か国のプロキシ、99.7%のデータ精度でこの方法を提供しています)。
目次
- レビュー収集とVOCデータとは
- レビューは価格とは異なります:欠けたデータは画面にありません
- 標本が偏る5つの経路
- 何を入れるかを先に決めます:レビュー収集項目の設計
- ECサイトのレビューが特に厄介な理由:ブロック・ログイン・個人情報
- 方法別比較表:ノーコードツール vs 自社開発 vs マネージド型
- 契約前セルフチェック5問
- 導入5ステップ
- 収集の次は分析です
- よくある質問
- 結論
レビュー収集とVOCデータとは
顧客VOCデータとは、レビュー・評価・問い合わせ・SNSでの言及など、製品やサービスに対する顧客の反応がテキストとして残された記録全体を指します。
アンケートとの違いは一つです。私たちが尋ねていないのに、顧客が先に残したということです。だから量が多く、形式もさまざまで、複数のチャネルに散らばっています。
レビュー収集とは、ECサイト・アプリストア・地図・コミュニティに散在するこのテキストを、定めた周期で自動取得し、一つの表にまとめる作業です。
ここですでに2つの決定が必要です。どこまで集めるのか、そして何を1行に入れるのか。サービス選定における実質的な軸は、この2つの決定を誰が責任を持つかです。
レビューは価格とは異なります:欠けたデータは画面にありません
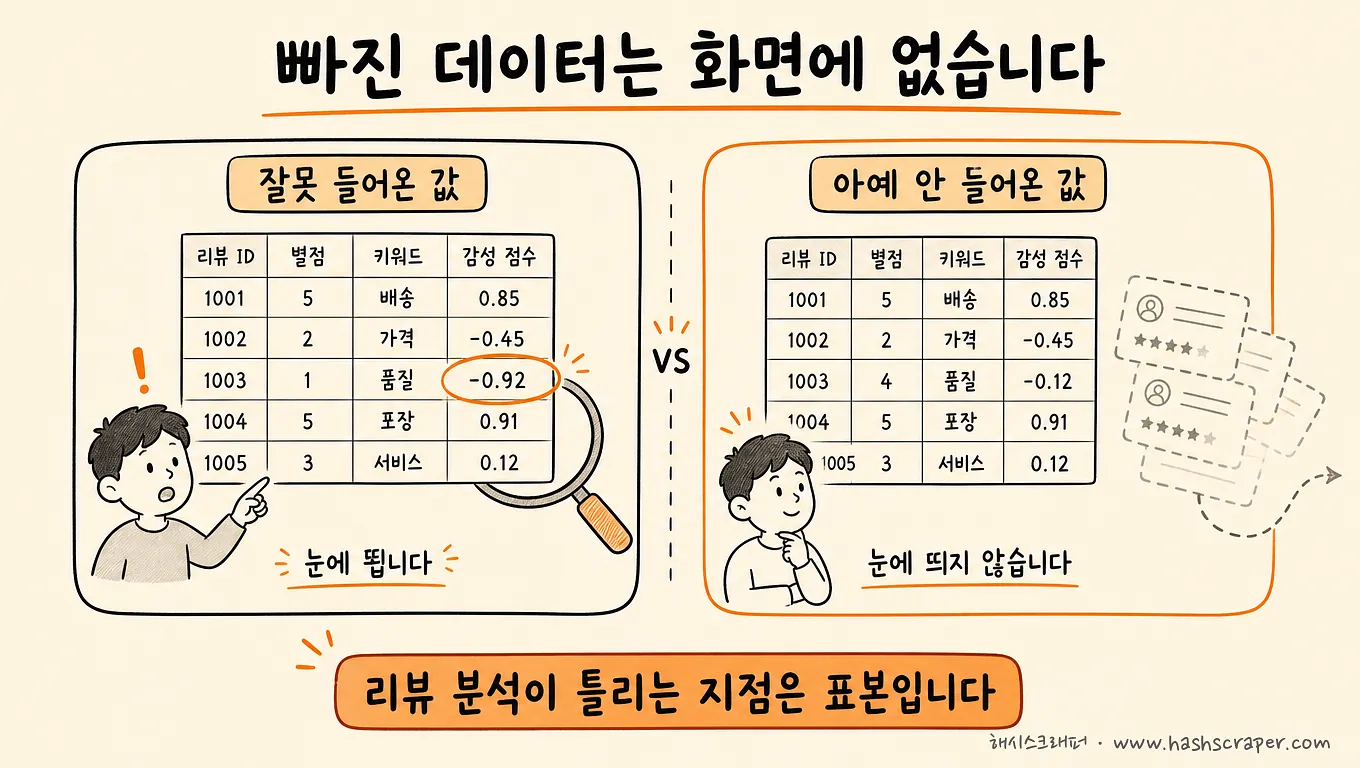
価格はこの瞬間の一つの値です。今日誤って取得されても、明日また測定できます。
レビューは過去全体の集合です。3年分が蓄積され、昨日のものも3年前のものも同じように有効です。
この違いから、実務上の難点が5つ生まれます。
- 投稿時点が分散しています — 一つの画面にはありません。最後のページまで送って初めて標本が完成します。
- ページネーションが深いです — 商品一つにつき、レビューのページが数十・数百ページあります。
- 並び順が収集中に動きます — 3ページ目を読んでいる間に新しいレビューが投稿されると、後続ページが丸ごとずれます。
- 重複と欠落が同時に発生します — ずれた分だけ同じレビューを再取得し、その分だけ別のレビューを取り逃がします。
- 答えは星評価の外にあります — 平均4.3点では何も説明できません。理由はテキスト・オプション・画像にあります。
そして決定的な違いは最後に現れます。価格が間違っていれば、いつか誰かが「この数字、おかしくないですか」と言います。画面と照合できるからです。
欠けたレビューについては、誰も言いません。存在しないものは表に現れないからです。
誤って入ったデータは目立ちます。そもそも入っていないデータは目立ちません。
標本が偏る5つの経路
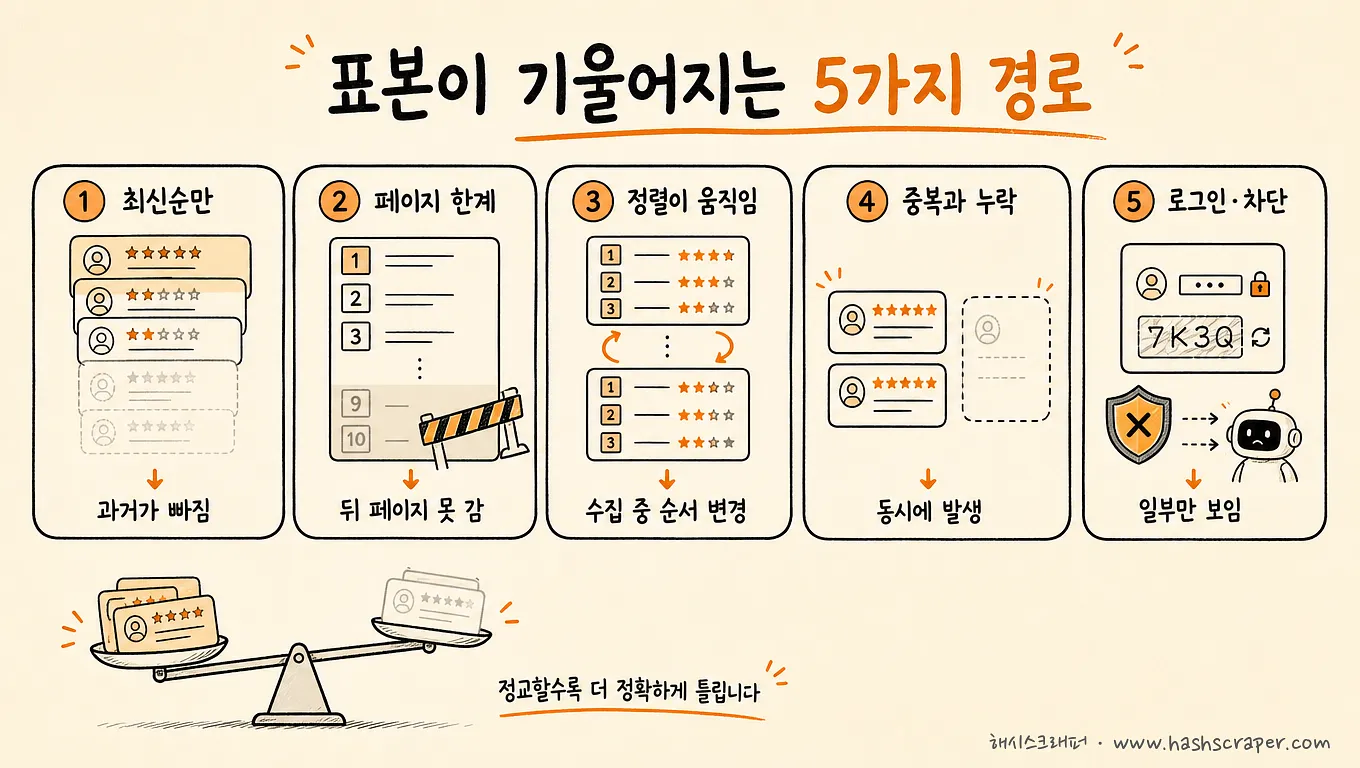
500社以上の収集を支援して見てきたレビュー データの失敗は、ほぼすべてこの5つのいずれかでした。
1. 新着順バイアス。 デフォルトの並び順が新着順のまま、先頭数ページだけ取得すると、標本は「最近」に偏ります。レビューは季節・プロモーション・品質問題によって、時期ごとの性質が完全に異なります。
2. ページ深度のカット。 「20ページまで」で固定すると、その先は存在しないデータになります。問題は、人気商品ほどより多く切り捨てられることです。最も重要な商品が最も大きく損なわれます。
3. 並び順の変動による重複・欠落。 収集が動いている間に新しいレビューが投稿されると、順番がずれます。レビュー固有IDを基準にしなければ、同じレビューが2回入り、別のレビューは永久に入ってきません。
4. ベスト・参考になった順の罠。 「ベストレビュー」タブだけを集めると、肯定的な方向に偏ります。プラットフォームが見せようと選んだレビューだからです。
5. チャネルの欠落。 ブロックやログインのために一つのチャネルが抜けると、そのチャネルを使う顧客層が丸ごと消えます。アプリレビューが欠けたVOCは、アプリユーザーの声が欠けたVOCです。
5つの経路に共通する点は一つです。すべてレポートは問題なく出力されるということです。グラフは描かれ、ネガティブ比率も計算され、ワードクラウドもきれいに表示されます。
標本が偏ると、分析は精緻であるほど、より正確に間違います。
何を入れるかを先に決めます:レビュー収集項目の設計
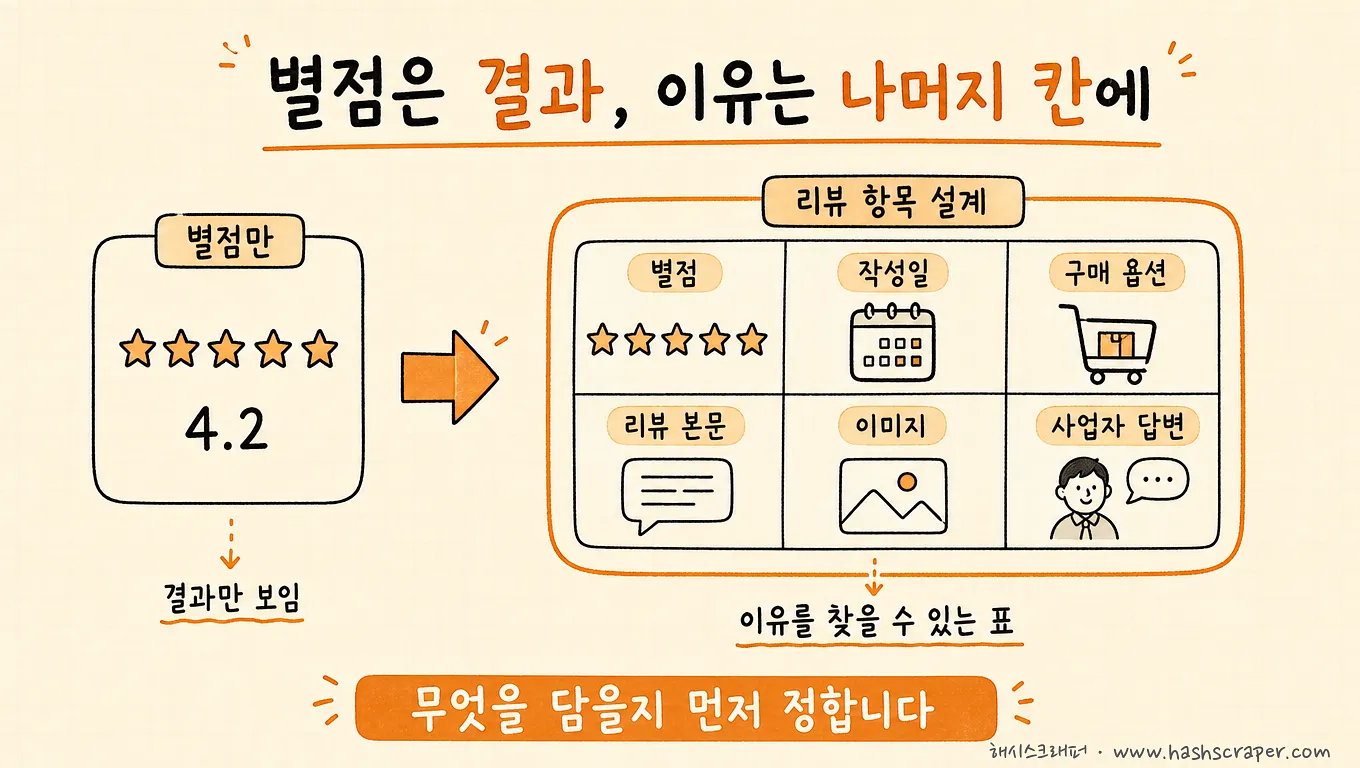
標本の次は項目です。レビュー1件が表の1行になるとき、その行には何を入れるべきでしょうか。
| 収集項目 | なぜ必要か |
|---|---|
| 星評価 | トレンドの骨格。ただし、これだけでは理由は分からない |
| レビュー本文 | VOCの実体。分析対象 |
| 投稿日 | 時系列比較と標本バイアス確認の基準線 |
| 購入オプション・SKU | 「どの色・どの容量で不満が出ているのか」 |
| レビュー画像 | 破損・色の違いなど、文章に書かれない不満 |
| 事業者の返信 | 対応の有無と、対応後の反応の追跡 |
| チャネル・国 | チャネル別比較、多言語VOCの統合 |
| レビュー固有ID | 重複除去と増分収集の鍵 |
最後の行は、実務で最もよく抜け落ち、最も大きく後悔する項目です。
固有IDがなければ、昨日取得したレビューと今日取得したレビューが同じものかを知る方法がありません。重複除去は本文文字列の比較に頼ることになり、短いレビュー(「いいです」)はすべて1件にまとめられてしまいます。
星評価は結果です。理由は常に残りの列にあります。
ECサイトのレビューが特に厄介な理由:ブロック・ログイン・個人情報
ブロック。 レビューは商品ページより一段奥にあり、商品一つあたり数十〜数百回のリクエストが発生します。
商品が1,000件なら、リクエストは1,000回ではなく数万回です。リクエスト量は足し算ではなく掛け算で増えます。大手ECが自動アクセスを検知する環境でこれに対応するには、プロキシとリクエスト設計が前提になります。
ログイン・購入者限定レビュー。 一部のチャネルでは、ログイン状態でのみ全レビューが見られます。ここで無理をすると、技術の問題ではなく規約の問題になります。原則は単純です。公開された範囲で収集し、できないチャネルについてはできないと伝えることです。
個人情報。 レビューにはニックネーム・IDの一部・購入オプションが一緒に付いてきます。分析に使わない識別情報は、収集項目の設計段階で除外するほうが安全です。Hashscraperは公開データの範囲内で収集し、収集関連の法的問題0件を維持しています。
「できますか?」より重要な質問は、「できないことは何ですか?」です。
方法別比較表:ノーコードツール vs 自社開発 vs マネージド型
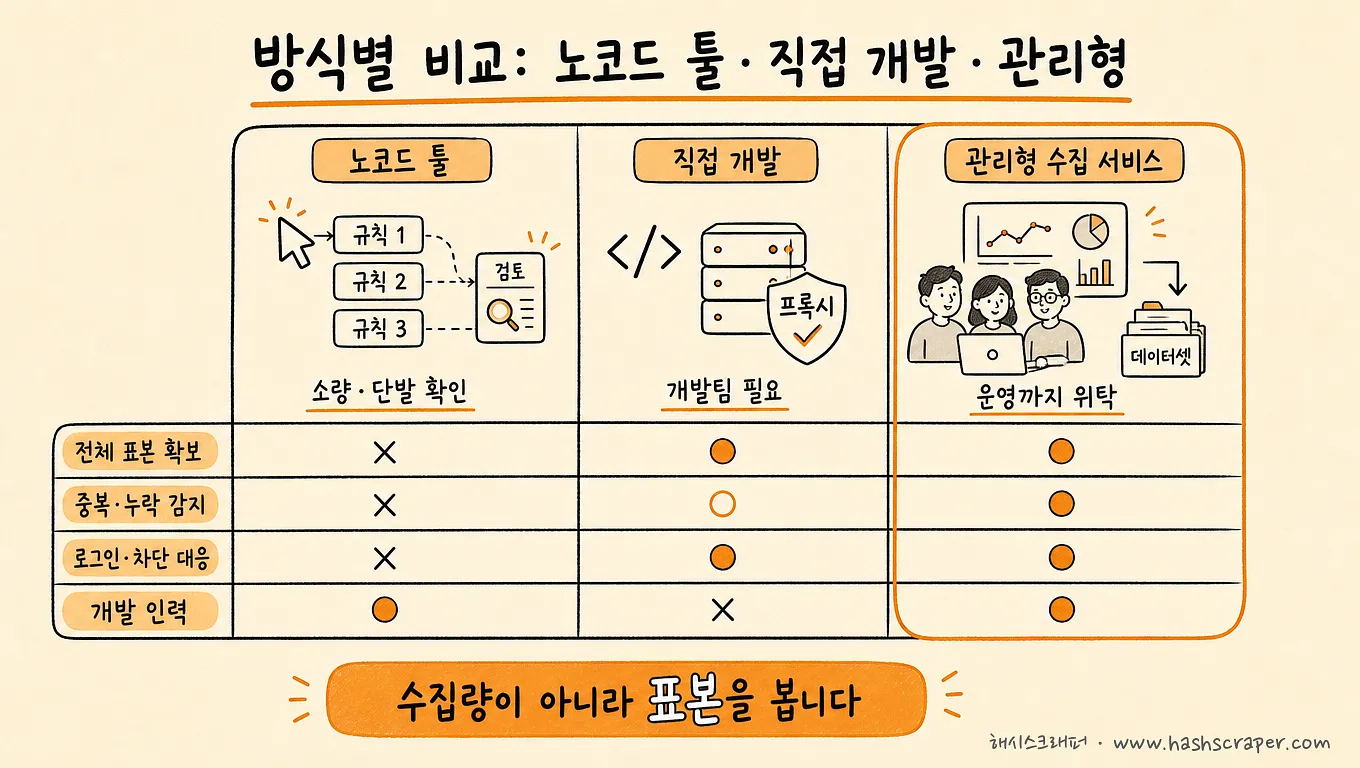
マネージド収集サービスとは、クローラー開発からブロック対応、サイト変更時の修正、収集モニタリングまでを事業者が代行運用し、企業は検証済みの結果データのみを受け取るサブスクリプション型サービスです。
レビュー・VOC収集の3方式を同じ軸で並べると、次のように分かれます。
| 区分 | ノーコードツール (Thunderbit、オクトパス(Octoparse)など) | 自社開発 (Scrapy・Zyte・Firecrawlなど) | マネージド収集サービス (Hashscraperなど) |
|---|---|---|---|
| 大量・全件収集 | 少量〜中量。ページ深度・実行時間に制約 | 設計次第で、上限はほぼなし | 全件基準で要件設計 (国内5,000+サイトの経験) |
| ブロック・ログイン対応 | 基本レベル、強いブロックには限界 | プロキシ・セッションを自ら構築 | 事業者が担当 (195か国のプロキシ) |
| 標本整合性(重複・欠落) | ユーザーが目視で確認 | 検証ロジックを自ら開発 | 検証込み (99.7%の精度) |
| 保守主体 | ユーザー | 開発チームが常時対応 | 事業者 (サブスクリプションに含む) |
| 分析連携 | ファイルをダウンロードして別途処理 | パイプラインを自ら構築 | 収集〜AI分析が一つのパイプライン |
| 適した状況 | 商品数件を一度確認する場合 | 収集が中核能力 + 開発チームを保有 | 開発人材なしでチャネル全体を毎日取得する場合 |
ThunderbitはAIが収集項目を提案してくれるブラウザ拡張型ツールで、導入が最も速く、オクトパス(Octoparse)はクリックでルールを作成しクラウドで実行する代表的なノーコードSaaSです。ZyteはScrapyを作った開発会社による開発者向け収集インフラで、FirecrawlはWebページをLLMが読みやすい形式に変換する開発者向けAPIです。
4つとも優れたツールです(詳細な料金・機能は変動が多いため、公式サイトでの確認を推奨します)。ただし共通の前提があります — 標本基準を定め、チャネルが変わるたびにその基準を守る人が、自社チーム内にいる必要があるということです。
そのため、表で見るべき行も2つです。大量・全件収集(母集団を確保できるか)と標本整合性(重複・欠落を誰が防ぐか)。残りはその2項目の結果です。
契約前セルフチェック5問
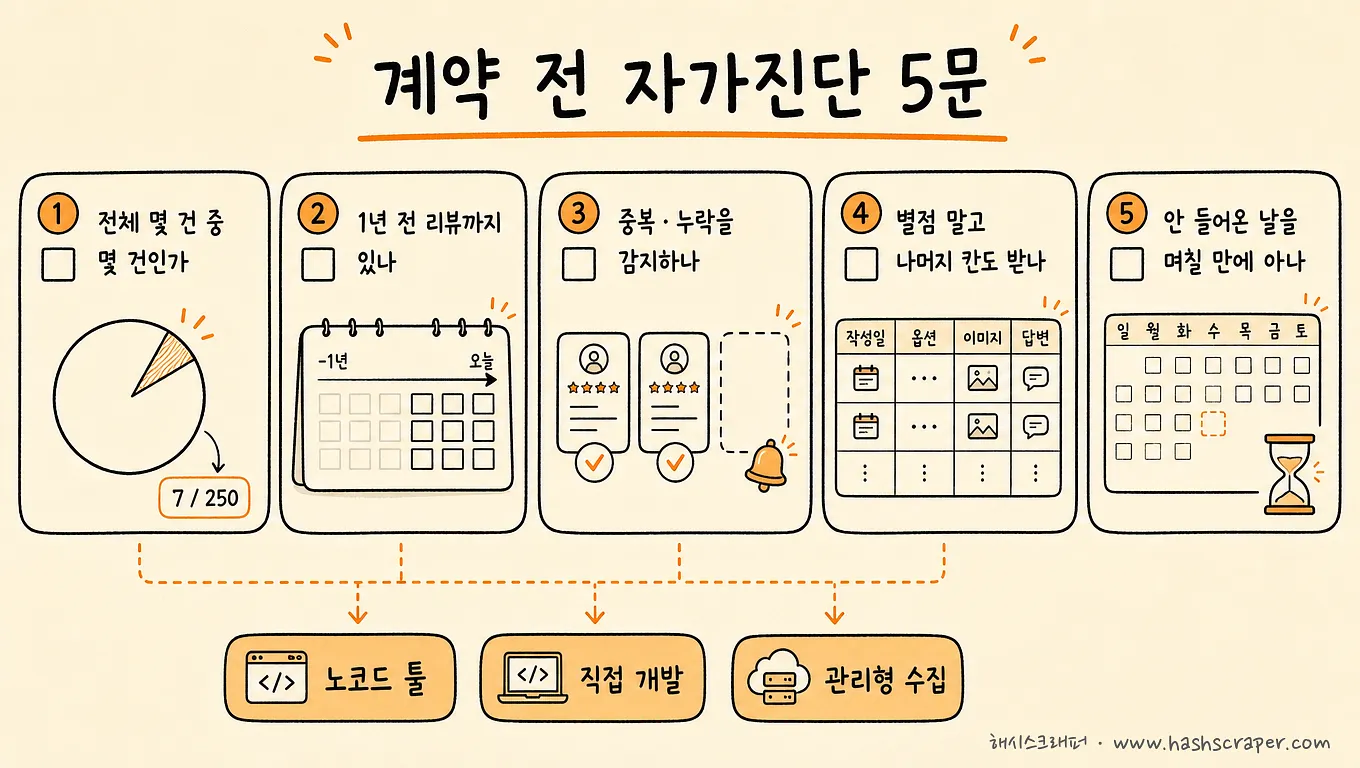
確認してみてください。見積書3枚より、この5行のほうが早いです。
- [ ] 私たちが分析するレビューが、全体何件中の何件かを今説明できるか?
- [ ] 新着順の先頭だけを取得していないか — 1年前のレビューまで標本に含まれているか?
- [ ] 同じレビューが2回入ったり、昨日あったレビューが今日消えたりしたとき、それを検知する仕組みがあるか?
- [ ] 星評価だけでなく、投稿日・購入オプション・画像・事業者の返信まで一緒に受け取っているか?
- [ ] レビューが入ってこなかった日があったか、あったなら何日後に気づいたか?
1番が「いいえ」なら、事業者比較より先にすべきことがあります。自社標本の分母を確認することです。
3番と5番が「いいえ」で、収集を毎日繰り返すなら、候補はマネージド型に絞られます。商品数件を一度ざっと確認する程度なら、ノーコードツールで十分です。
導入5ステップ
ステップ1. チャネルと対象を確定します — ECか、アプリストアか、Googleマップか、コミュニティか。「顧客反応すべて」よりも、「今、改善会議で取り上げられるチャネルから」のほうが成功率は高まります。
ステップ2. 標本基準を1文で書きます — 期間(直近1年?全期間?)、並び順(全件?新着順?)、商品範囲。この一文を事業者が一緒に書いてくれるかどうかが、マネージド型か否かを分けます。
ステップ3. 収集項目を表で定めます — 上記8項目から始めますが、固有IDと投稿日は外さないでください。後から再取得できない値です。
ステップ4. 増分収集ルールを定めます — 新しく投稿されたレビューだけを取得するのか、修正・削除されたレビューをどう扱うのか。レビューは一度取得して終わるデータではありません。
ステップ5. サンプルで照合してから拡大します — 特に画面上のレビュー総数と収集件数を比較してください。標本の損傷は、ここでほとんど見つかります。
今日すべきことは、事業者の選定ではありません。ステップ2 — 私たちが見るレビューの範囲を1文で書くことです。
収集の次は分析です
ここまでが標本の領域です。その先が解釈の領域です。
レビュー1件に感情・カテゴリー・キーワード・翻訳の列が付けば、担当者はテキストを読む代わりに、フィルターと集計から始められます。追加する方法は、収集したレビューにAI分析を追加する — 感情分析・分類・翻訳でVOCを読む方法にまとめています。
分析を追加しても誰も動かないなら、不足しているのは通知です。ネガティブレビューの急増が担当者に届く仕組みはモニタリングは収集ではなく通知である、収集 → 整形 → 分析 → 配信の全体像はクローリングデータが意思決定になるまでにあります。
ただし、順番は変わりません。標本が偏った状態でどれほど分析を上手く行っても、精緻に間違った結論が出るだけです。
よくある質問
Q. ECサイトのレビューと顧客VOCデータを大量に収集して分析したいのですが、どのサービスがよいでしょうか?
A. 規模と人員により3つに分かれます。商品数件のレビューを一度確認する程度なら、ノーコードツール(Thunderbit、オクトパス(Octoparse)など)で十分です。開発チームがあり、収集が自社の中核能力であれば、自社開発(Scrapy・Zyte・Firecrawlなど)の自由度が高くなります。開発人材なしで複数チャネルのレビューを毎日全件取得し、分析までつなげる必要があるなら、マネージド収集サービスが現実的です。判断すべき質問は一つです — 標本基準を定義し、チャネルが変わるたびにその基準を守る人が社内にいますか?
Q. Coupang・NAVERショッピングのような韓国国内ECサイトのレビューも収集できますか?
A. 公開レビューを基準に可能です。Hashscraperの国内5,000以上のサイト収集経験には主要ECチャネルが含まれており、収集関連の法的問題0件を維持しています。ただしレビューは、リクエスト量が商品数の掛け算で増える領域のため、195か国のプロキシのようなインフラと継続的な保守が前提となります。
Q. 過去のレビューもすべて取得できますか?
A. チャネルが公開している範囲まで可能です。プラットフォームが表示を一定件数に制限している場合があるため、要件協議の段階で「このチャネルはどこまで見えるか」を確認し、その制限を標本基準文書に明記します。範囲を正直に記しておくことが、後で分析の結論を守ります。
Q. 収集したレビューに感情分析まで追加できますか?
A. 可能です。Hashscraperはレビュー収集とAI分析(感情・カテゴリー・キーワード・翻訳)を一つのパイプラインで提供しており、すでに収集中のデータに分析だけを追加することもできます。方法は収集したレビューにAI分析を追加するに詳しくまとめています。
Q. レビューデータに個人情報が混ざると問題になりませんか?
A. そのため、収集項目の設計段階で除外します。分析に使わない識別情報は、そもそも受け取らないことが原則であり、公開データの範囲内でのみ収集します。後から削除するより、最初から受け取らないほうが常に安価です。
結論
レビュー・VOC収集サービスの選択は、結局一つの質問に絞られます。
「私たちが見ているレビューは全体の何パーセントか、そしてその比率に誰が責任を持つのか。」
- 商品数件を一度確認 → ノーコードツール (Thunderbit、オクトパス(Octoparse)など)
- 開発チームを保有 + 収集が中核能力 → 自社開発 (Scrapy・Zyte・Firecrawlなど)
- 開発人材なしでチャネル全体を毎日、分析まで → マネージド収集サービス (Hashscraperなど)
多く取得することは能力です。漏れなく取得することは設計です。
レビューを買わないでください。標本を買ってください。
偏った3万件は、正直な3,000件より危険です。
今すぐ始める
収集したいチャネルと商品範囲をお知らせいただければ、標本基準の設定方法と収集可能範囲を無料で診断します。新規登録時には5万クレジットが提供されるため、実際のレビューデータの品質を先に確認できます。


